


本文基于 Kubernetes v1.37(当前最新 v1.37.1,维护 1.37/1.36/1.35)官方文档重写,重点讲清控制循环、调度、网络、存储、安全等机制,再落到生产实践。旧笔记停留在 1.17/1.18 时代,Docker 运行时、调度器、Service、证书和多个 API 都已经发生变化,旧内容不再作为操作依据。
最后更新:2026-10-22
Kubernetes 是什么
Kubernetes 是一个容器编排系统。它不直接“命令”应用怎么运行,而是让用户声明期望状态,由控制器不断把实际状态调整到期望状态。
两个核心概念:
- 声明式 API:用户提交 YAML,描述“我要什么”,而不是“第一步做什么、第二步做什么”
- 控制循环(reconciliation loop):控制器 watch 对象变化,比较期望状态和实际状态,执行动作缩小差距
例如 Deployment 期望 3 个副本,实际只有 2 个,ReplicaSet 控制器会创建 1 个 Pod;某个 Pod 挂了,控制器会再补一个。Kubernetes 的“自愈”本质上就是控制循环。

图 1:Kubernetes 官方组件架构图
集群架构
Kubernetes 集群分为控制面和节点。
控制面
| 组件 | 职责 |
|---|---|
| kube-apiserver | 唯一入口,负责认证、鉴权、准入、校验、读写 etcd |
| etcd | 强一致的键值存储,保存集群全部状态 |
| kube-scheduler | 为未绑定的 Pod 选择节点 |
| kube-controller-manager | 运行各种控制器:Deployment、ReplicaSet、Node、Job、EndpointSlice 等 |
| cloud-controller-manager | 对接云厂商的负载均衡、节点、路由等能力 |
kube-apiserver 是无状态的,可以水平扩展;etcd 是有状态的,必须保证 quorum。生产环境控制面至少 3 个节点,etcd 通常 3 或 5 副本。
节点
| 组件 | 职责 |
|---|---|
| kubelet | 与 apiserver 交互,管理本节点 Pod 和容器 |
| kube-proxy | 同步 Service/EndpointSlice 到 iptables、nftables 或 IPVS 规则 |
| container runtime | 通过 CRI 运行容器,生产常用 containerd 或 CRI-O |
| CNI 插件 | 为 Pod 分配 IP、配置网络、实现 NetworkPolicy |
dockershim 已在 v1.24 移除,Docker Engine 不再是 kubelet 直接支持的运行时。如果必须使用 Docker,需要额外部署 cri-dockerd。rkt、frakti 已不再维护。
一次请求的链路
kubectl → kube-apiserver → etcd |
kubectl apply只是把对象写入 apiserver- 控制器和调度器通过 watch 感知变化
- kubelet watch 绑定到本节点的 Pod,调用 CRI 启动容器
- kube-proxy watch Service/EndpointSlice,更新转发规则

图 2:cloud-controller-manager 把云厂商能力从核心组件中拆出
API 对象模型
所有 Kubernetes 对象都有三个顶层字段:
apiVersion: apps/v1 |
metadata:名称、命名空间、标签、注解、ownerReferences、finalizersspec:期望状态,由用户或控制器写入status:实际状态,由控制器或 kubelet 写入
命名空间、标签与注解
- Namespace:逻辑隔离,不是网络隔离;RBAC、ResourceQuota、NetworkPolicy 常按 Namespace 划分
- Label:用于选择和分组,Service、Deployment、NetworkPolicy 都靠 label selector 找对象
- Annotation:存放非标识性元数据,例如
kubectl.kubernetes.io/last-applied-configuration - ownerReferences:表达从属关系,删除父对象时决定是否级联删除
- finalizers:删除前的清理钩子,finalizer 未移除时对象会一直处于 Terminating
API 版本与弃用
当前常用稳定版本:
| 资源 | apiVersion |
|---|---|
| Pod、Service、ConfigMap、Secret、Namespace、Node | v1 |
| Deployment、StatefulSet、DaemonSet、ReplicaSet | apps/v1 |
| Job、CronJob | batch/v1 |
| HorizontalPodAutoscaler | autoscaling/v2 |
| PodDisruptionBudget | policy/v1 |
| Ingress、NetworkPolicy、IngressClass | networking.k8s.io/v1 |
| StorageClass、CSIDriver、VolumeAttachment | storage.k8s.io/v1 |
| Role、ClusterRole、RoleBinding、ClusterRoleBinding | rbac.authorization.k8s.io/v1 |
已经移除、不要再使用的:
extensions/v1beta1的 Deployment、Ingress、NetworkPolicy 等apps/v1beta1、apps/v1beta2batch/v1beta1CronJob(v1.25 移除)autoscaling/v2beta2(v1.26 移除)policy/v1beta1PodDisruptionBudget、PodSecurityPolicy(PSP 在 v1.25 移除)discovery.k8s.io/v1beta1EndpointSlice
升级前先用 kubectl api-resources、kubectl get --raw 或 pluto/kubent 扫描已移除 API。
Pod
Pod 是 Kubernetes 最小的调度和运行单元。一个 Pod 可以包含一个或多个容器,它们共享:
- 网络命名空间:同一个 Pod 内容器共享 IP 和端口空间,可以用
localhost互访 - 存储卷:Volume 挂载到 Pod 级别,可被多个容器共享
- 生命周期:Pod 内容器一起调度到同一个节点
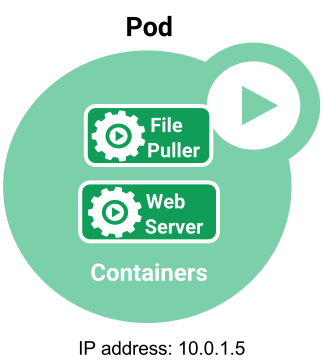
图 3:Pod 内容器共享网络命名空间和存储卷
pause 容器
每个 Pod 都有一个不可见的 pause 容器,它持有 Pod 的网络命名空间。业务容器加入这个命名空间,因此共享网络栈。pause 容器非常轻量,只负责“占住”命名空间。
Pod 生命周期
Pending:已创建,但还没被调度或镜像未就绪Running:已绑定节点,至少一个容器在运行Succeeded:所有容器成功退出(Job 常见)Failed:至少一个容器失败退出Unknown:无法获取状态,通常是节点通信问题
容器状态还有 Waiting、Running、Terminated。常见等待原因:ContainerCreating、ImagePullBackOff、CrashLoopBackOff。
探针
- startupProbe:启动探针,成功前不执行 liveness/readiness;适合启动慢的应用
- readinessProbe:就绪探针,失败时从 Service Endpoint 摘除,不重启容器
- livenessProbe:存活探针,失败时重启容器
未配置探针时,kubelet 不执行任何探测;容器只要进程在运行就视为 Running,不会因为应用假死被重启,也不会从 Service 摘除。
startupProbe: |
探针不要配置得过于激进,否则会把正常启动或短暂抖动的容器杀掉。
资源与 QoS
resources: |
requests用于调度,决定 Pod 能放到哪些节点limits用于运行时限制,CPU 超限被节流,内存超限可能被 OOM kill- QoS 分
Guaranteed、Burstable、BestEffort,节点资源紧张时优先驱逐 BestEffort
优雅终止
删除 Pod 时:
- Pod 进入 Terminating
- 从 Service Endpoint 摘除
- 执行 preStop hook
- 发送 SIGTERM
- 等待
terminationGracePeriodSeconds - 超时后 SIGKILL
应用需要正确处理 SIGTERM,并在优雅期内完成请求排空。只配置 preStop sleep 而不处理 SIGTERM,仍然可能丢请求。
原生 Sidecar
Kubernetes 支持把 initContainer 的 restartPolicy 设为 Always,作为原生 Sidecar 容器。它在业务容器之前启动,并在业务容器全部停止后才终止,随 Pod 生命周期运行,适合日志代理、代理网关等场景。
工作负载控制器
Deployment 与 ReplicaSet
Deployment 管理 ReplicaSet,ReplicaSet 管理 Pod。滚动更新时,Deployment 创建新 ReplicaSet,逐步扩容新 RS、缩容旧 RS。
默认 maxUnavailable=25%、maxSurge=25%。对 3 副本:
maxUnavailable向下取整为 0maxSurge向上取整为 1- 升级期间至少 3 个可用,最多 4 个 Pod
默认保留最近 10 个旧 ReplicaSet(revisionHistoryLimit),超出后旧 RS 被回收,删除后无法回滚到该 revision。
apiVersion: apps/v1 |
回滚:
kubectl rollout history deployment/nginx |
StatefulSet
StatefulSet 为每个 Pod 提供:
- 稳定的 DNS 名称:
<pod>.<service>.<namespace>.svc.cluster.local - 稳定的存储:通过
volumeClaimTemplates为每个 Pod 创建独立 PVC - 有序的创建、删除、滚动更新
Pod IP 不保证不变;稳定的是 DNS 名称和存储。spec.serviceName 必须指向一个 Headless Service。
apiVersion: apps/v1 |
DaemonSet
DaemonSet 在每个(或指定)节点运行一个 Pod,常用于日志、监控、CNI、kube-proxy。新增节点会自动调度,删除节点会自动清理。
Job 与 CronJob
Job 的 restartPolicy 只能是 Never 或 OnFailure。完成的 Pod 默认保留为 Completed,可以通过 ttlSecondsAfterFinished 自动清理。
CronJob 使用 batch/v1,支持 concurrencyPolicy、startingDeadlineSeconds、successfulJobsHistoryLimit。
HPA

图 4:HPA 根据指标调整副本数
apiVersion: autoscaling/v2 |
HPA 依赖 metrics-server 或自定义指标适配器;没有 requests 时,CPU 利用率无法计算。
PDB
PDB 限制自愿中断(drain、升级)时同时不可用的 Pod 数量:
apiVersion: policy/v1 |
PDB 不保证节点故障时的可用性,只约束自愿中断。
Service 与网络
Service
Service 为一组 Pod 提供稳定的虚拟 IP 和 DNS 名称。Pod IP 会变,Service 不会。
类型:
ClusterIP:集群内虚拟 IP,默认类型NodePort:在每个节点监听一个端口,默认范围 30000-32767LoadBalancer:通过云厂商或 MetalLB 等提供外部负载均衡ExternalName:只做 DNS CNAME,不做端口转发Headless(clusterIP: None):不分配 VIP,直接返回 Pod IP,常用于 StatefulSet
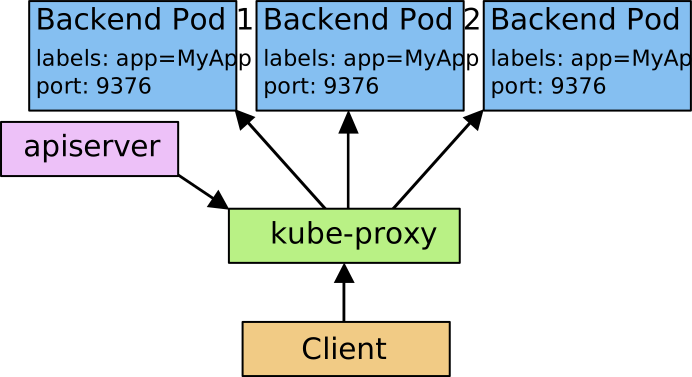
图 5:Service 通过 selector 选择 Pod
EndpointSlice
Service 的后端由 EndpointSlice 表示。新实现应使用 discovery.k8s.io/v1 EndpointSlice;旧的 Endpoints API 已废弃,不支持双栈,规模大时会被截断。
kubectl get endpointslices -l kubernetes.io/service-name=nginx |
kube-proxy
kube-proxy watch Service 和 EndpointSlice,把虚拟 IP 转发规则同步到节点。

图 6:iptables 模式下 Service 到 Pod 的转发
模式:
iptables:当前常见默认,规则多时同步和匹配成本会上升nftables:新版本可用,规则管理更高效ipvs:已进入废弃流程,新集群不建议作为主模式
iptables/nftables 模式下,NodePort 不是 kube-proxy 进程监听端口,而是转发规则;ss -lntp 看不到。
externalTrafficPolicy

图 7:externalTrafficPolicy 对源 IP 和转发路径的影响
Cluster:流量可以转发到其他节点的 Pod,源 IP 可能被 SNATLocal:只转发到本节点 Pod,保留客户端源 IP,但节点没有 Pod 时流量会失败
Ingress 与 Gateway API
Ingress 使用 networking.k8s.io/v1,通过 ingressClassName 绑定 Ingress Controller:
apiVersion: networking.k8s.io/v1 |
Ingress-NGINX 已于 2026-03 后停止维护,新项目应评估 Gateway API。Gateway API 通过 CRD 提供 GatewayClass、Gateway、HTTPRoute,表达能力更强,但 CRD 需要单独安装。
DNS
集群内 DNS 由 CoreDNS 提供,Service 的域名格式:
<service>.<namespace>.svc.cluster.local |
Headless Service 会返回每个 Pod 的 A/AAAA 记录。ndots:5 可能导致不必要的 DNS 查询,跨命名空间访问时建议使用 FQDN 或调整 dnsConfig。

图 8:NodeLocal DNSCache 减少 DNS 跨节点查询
NetworkPolicy
NetworkPolicy 是命名空间级的 L3/L4 访问控制,必须由 CNI 实现(Calico、Cilium、Antrea 等)。Flannel 本身不执行 NetworkPolicy,需要 Canal 或 Calico。
默认拒绝入站:
apiVersion: networking.k8s.io/v1 |
放行来自同一命名空间的流量:
apiVersion: networking.k8s.io/v1 |
NetworkPolicy 不是身份认证,不能替代 mTLS 和 AuthorizationPolicy。
存储
Volume
Pod 内容器共享 Volume。常见类型:
emptyDir:Pod 生命周期内的临时目录,容器重启不丢,Pod 删除即丢hostPath:挂载节点目录,和节点强绑定,生产慎用configMap、secret:把配置和敏感数据挂载为文件projected:把多个来源(Secret、ConfigMap、Downward API、ServiceAccount token)投影到一个目录persistentVolumeClaim:挂载 PVCnfs、csi:网络存储和 CSI 驱动
gitRepo 卷已移除,需要仓库内容时用 initContainer 克隆到 emptyDir。
Secret 默认只是 base64 编码,不是加密。生产应启用 etcd 静态加密(EncryptionConfiguration/KMS v2),并限制 RBAC。
PV、PVC 与 StorageClass
- PV:集群级存储资源,描述“有什么存储”
- PVC:命名空间级请求,描述“我要多大、什么访问模式”
- StorageClass:动态供给模板,描述“用什么 provisioner 创建 PV”
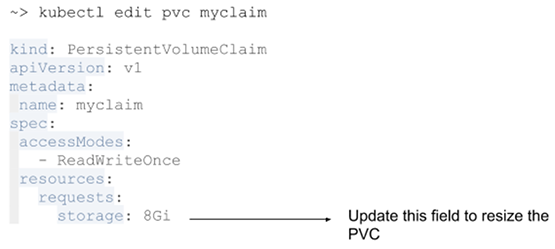
图 9:PVC、PV 与 StorageClass 的关系(Kubernetes 官方博客)
访问模式:
ReadWriteOnce(RWO):单节点读写,同一节点上多个 Pod 可能同时挂载ReadOnlyMany(ROX):多节点只读ReadWriteMany(RWX):多节点读写ReadWriteOncePod(RWOP):单 Pod 读写,仅 CSI 支持
动态供给:
apiVersion: storage.k8s.io/v1 |
provisioner填 CSI 驱动名称,不再使用旧的kubernetes.io/*WaitForFirstConsumer让 PV 在 Pod 调度后再创建,避免拓扑不匹配reclaimPolicy: Retain可以在 PVC 删除后保留数据- 扩容需要
allowVolumeExpansion: true且 CSI 支持
CSI
生产存储统一使用 CSI:
- external-provisioner:动态创建 PV
- external-attacher:挂载/卸载
- external-resizer:扩容
- external-snapshotter:快照
- CSIDriver、CSINode:描述驱动能力和节点拓扑
in-tree 存储插件已逐步迁移到 CSI,新集群不要再用 in-tree provisioner。
快照与恢复
快照依赖 VolumeSnapshot CRD(通常需单独安装):
apiVersion: snapshot.storage.k8s.io/v1 |
恢复时用 dataSource 指向 VolumeSnapshot 创建新 PVC。
调度
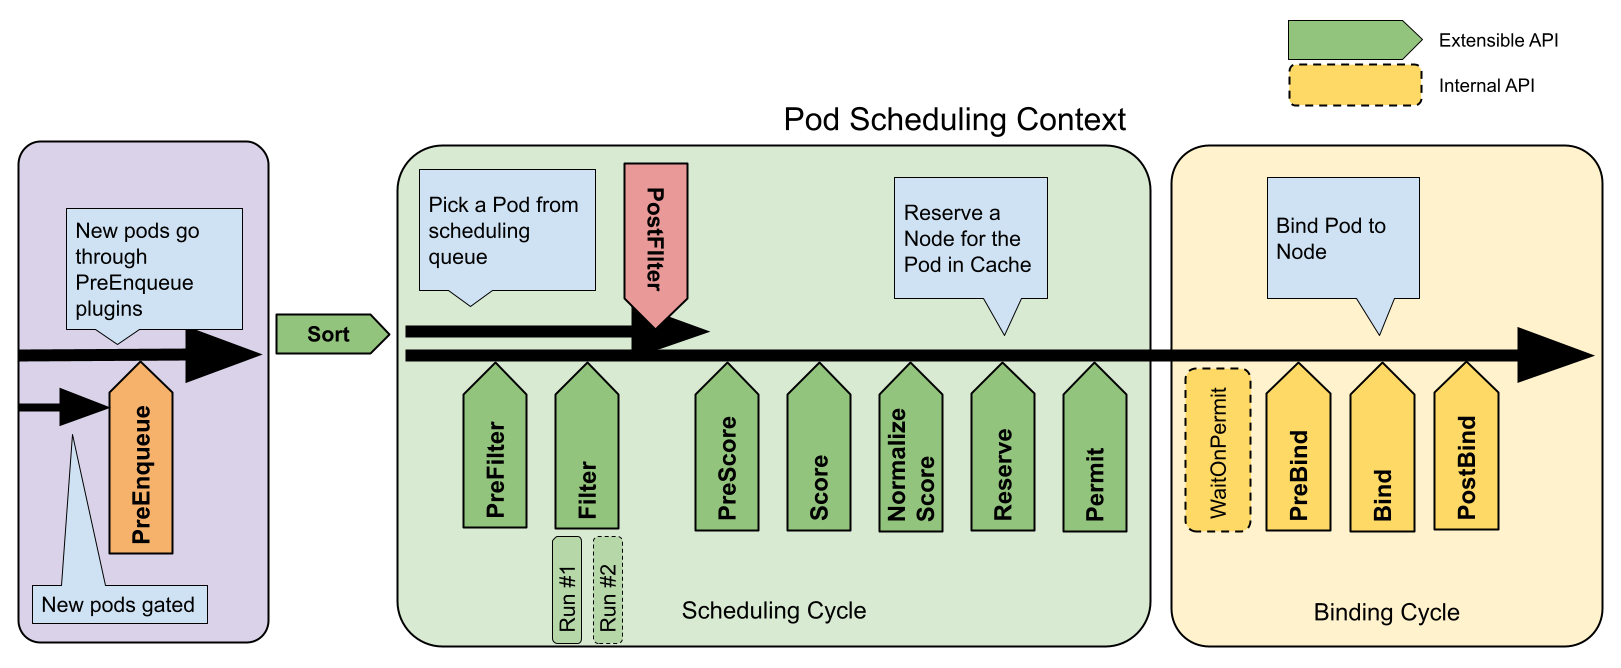
图 10:kube-scheduler 的调度框架扩展点
调度流程:
- Filter:过滤不满足条件的节点,例如资源不足、污点不匹配、亲和性不满足
- Score:给候选节点打分,例如资源均衡、拓扑分布、镜像本地性
- Bind:把 Pod 绑定到得分最高的节点
常见调度约束:
nodeSelector:最简单的标签选择nodeAffinity:节点亲和性,支持硬性和软性podAffinity/podAntiAffinity:Pod 之间就近或互斥topologySpreadConstraints:按拓扑域均匀分布taints/tolerations:节点排斥 Pod,Pod 声明容忍priorityClassName:优先级和抢占
affinity: |
资源与容量:

图 11:节点 Allocatable 与 Pod 资源请求
节点可分配资源 = Capacity - 系统保留 - kubelet 保留 - 驱逐阈值。调度只看 requests,不看实际使用量。
安全

图 12:Kubernetes API 请求的认证、鉴权、准入流程
认证
kube-apiserver 支持:
- X.509 客户端证书
- ServiceAccount token(TokenRequest/projected token)
- OIDC
- Webhook token authentication
- Bootstrap token
不要在集群里使用静态密码文件或 Basic Auth,这些方式已不再适合生产。
鉴权
常用模式是 RBAC:
apiVersion: rbac.authorization.k8s.io/v1 |
鉴权模块按 --authorization-mode 顺序检查,第一个明确 allow 或 deny 的结果生效;全部无意见时拒绝。RBAC 没有 deny 规则,最小权限通过“只授予需要的 verb/resource”实现。
准入控制
请求通过认证和鉴权后,还要经过准入控制:
- MutatingAdmissionWebhook:修改对象,例如注入 Sidecar
- ValidatingAdmissionWebhook:校验对象
- Pod Security Admission:按命名空间执行
privileged、baseline、restricted - ValidatingAdmissionPolicy:用 CEL 写校验规则,无需 Webhook
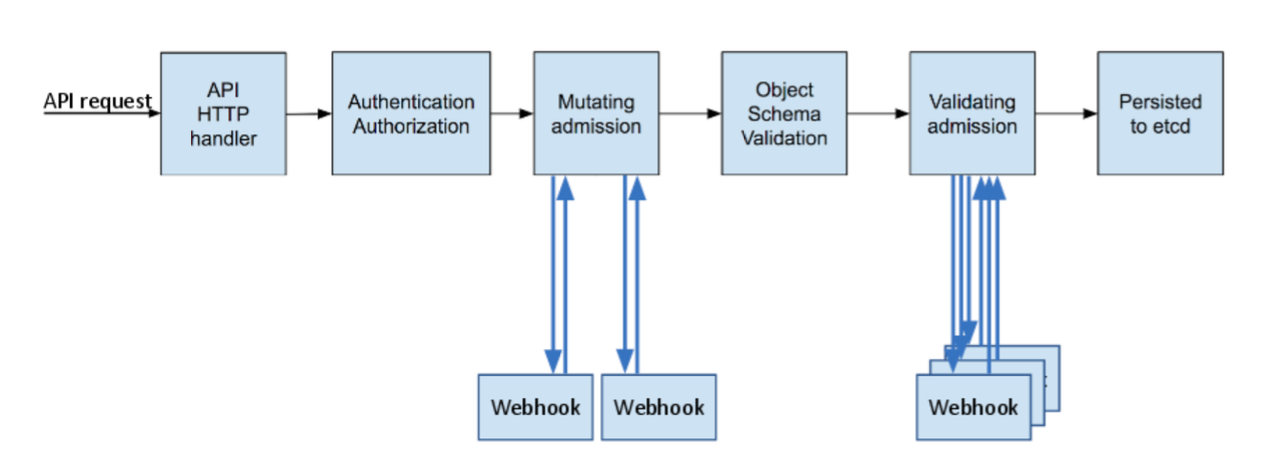
图 13:准入控制阶段(Kubernetes 官方博客)
PodSecurityPolicy 已在 v1.25 移除,使用 Pod Security Admission:
metadata: |
SecurityContext
securityContext: |
runAsNonRoot防止容器以 root 启动allowPrivilegeEscalation: false禁止提权capabilities.drop: ["ALL"]裁剪能力seccompProfile: RuntimeDefault启用默认 seccompreadOnlyRootFilesystem限制可写层
Secret
- 默认只做 base64,不是加密
- 生产启用 etcd 静态加密(KMS v2)
- 用 RBAC 限制 Secret 读取
- 优先用 volume 挂载,环境变量会留在进程环境里
- 考虑 External Secrets Operator 或 Vault 等外部密钥管理
集群运维
kubeadm 高可用
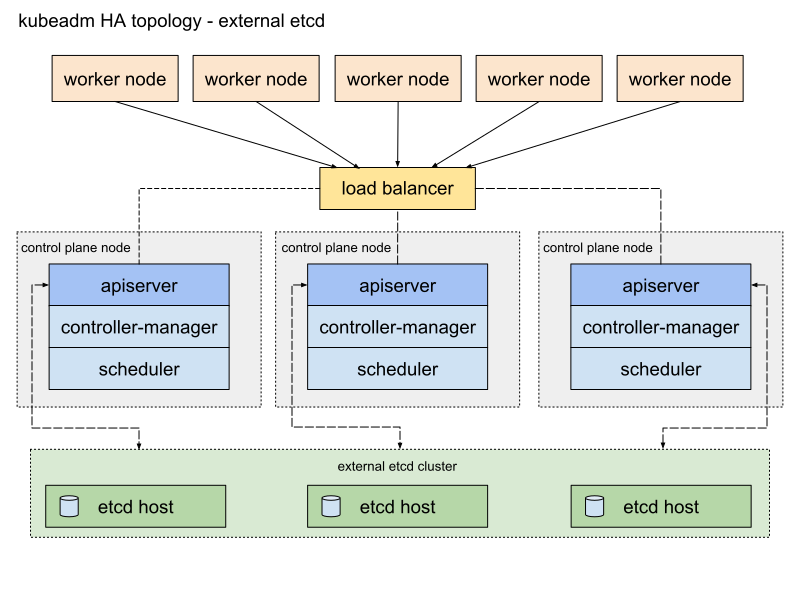
图 14:kubeadm 高可用集群(外部 etcd)
生产控制面至少 3 个节点,etcd 3 或 5 副本。负载均衡器放在 apiserver 前面,kubelet 和 kubectl 通过 VIP 访问。
版本升级
原则:
- 一次只升一个 minor
- 先控制面,再 kubelet/kube-proxy,最后工作负载
- 升级前检查已移除 API 和版本偏差
- kubelet 最多可落后 apiserver 3 个 minor,kubectl 支持 ±1 个 minor,具体以 Version Skew Policy 为准
kubeadm upgrade plan |
证书
kubeadm certs check-expiration |
kubeadm 默认 CA 有效期较长,叶子证书通常 1 年。升级时注意轮换,kubelet 客户端证书可以开启自动轮换。
etcd 备份
不要直接复制 etcd 数据目录,使用快照:
etcdctl snapshot save snapshot.db \ |
定期做恢复演练。etcd 要关注 quorum、defrag 和 compaction。
节点维护
kubectl cordon <node> |
drain 会遵守 PDB,但不会保证节点故障时的可用性。关键服务要多副本、反亲和、PDB 和 topologySpreadConstraints 一起用。
自动扩缩容
- HPA:按指标扩 Pod 副本
- VPA:调整 Pod requests/limits
- Cluster Autoscaler:按 Pending Pod 扩节点

图 15:VPA 架构
VPA 需要单独部署 CRD 和组件;和 HPA 同时使用时要注意指标冲突。
可观测性
- metrics-server:提供 Resource Metrics API
- Prometheus + Grafana:集群、节点、Pod、控制器指标
- 日志:Fluent Bit/Vector → Loki/Elasticsearch
- 事件:
kubectl get events --sort-by=.lastTimestamp - 审计日志:apiserver audit policy
Heapster 已移除,不要再用。
排障
常用命令
kubectl get pods -A -o wide |
节点侧:
crictl ps |
常见状态
| 状态 | 常见原因 |
|---|---|
| Pending | 资源不足、污点、亲和性不满足、PVC 未绑定 |
| ImagePullBackOff | 镜像不存在、仓库认证失败、网络不通 |
| CrashLoopBackOff | 应用启动失败、配置错误、依赖不可用 |
| OOMKilled | 超过 memory limit |
| Evicted | 节点资源压力,被 kubelet 驱逐 |
| Terminating 卡住 | finalizer 未处理、kubelet 异常 |
| Completed | Job 正常结束,不是故障 |
Service 不通
kubectl get endpointslices看后端是否存在kubectl get svc看 selector、port、targetPort- Pod 内
getent hosts <service>验证 DNS - 检查 NetworkPolicy 是否拦截
- 检查 kube-proxy 模式和规则
- 必要时在 Pod 或节点抓包
DNS 问题
- CoreDNS Pod 是否 Running
/etc/resolv.conf的 nameserver 和 search 域ndots是否导致大量无效查询- NetworkPolicy 是否放行 UDP/TCP 53
- 跨命名空间访问使用 FQDN
企业实践
企业落地 Kubernetes 的难点不在“把 Pod 跑起来”,而在隔离、可预期变更、容量、安全和故障处理。下面按主题展开。
多租户与隔离
先选隔离级别:
- 软多租户:共享集群 + Namespace,成本低,隔离靠 RBAC、ResourceQuota、NetworkPolicy、PSA
- 硬多租户:独立集群、vCluster 或 Capsule,隔离强,成本和运维复杂度高
Namespace 设计:
- 按团队、环境、业务域划分,不要一个 Namespace 塞所有东西
- 命名规范建议
<team>-<env>-<domain>,便于配额、RBAC 和成本分摊 - 生产和测试分 Namespace 或分集群,避免误操作
- 系统组件、Ingress、监控、日志使用独立 Namespace
配额与限制:
- ResourceQuota 限制 Namespace 总量,LimitRange 提供默认 requests/limits
- 只配 Quota 不配 LimitRange,容易出现 Pod 没写 requests 被拒绝,或 BestEffort 泛滥
- 配额要留 burst 余量,否则滚动更新时新 Pod 可能创建失败
- 配额不是容量规划,容量还要看节点池和 autoscaler
网络与安全隔离:
- NetworkPolicy 默认拒绝,按需放行 DNS、监控、入口和依赖
- PSA 至少 baseline,对外服务用 restricted
- 限制可用 StorageClass、镜像仓库、NodePort 和 LoadBalancer
- 强隔离场景考虑 vCluster、Capsule 或独立集群,不要只靠 Namespace
配置与发布管理
GitOps:
- 所有对象进 Git,Argo CD/Flux 同步,禁止手工
kubectl edit生产 - 环境差异用 Kustomize overlay 或 Helm values,不要复制多份 YAML
- 敏感信息不要进 Git,用 External Secrets、Sealed Secrets 或 Vault
- 集群组件和应用配置分开仓库或分目录,避免权限和变更耦合
CI 校验:
kubectl apply --dry-run=server做服务端校验kubectl diff预览变更- kubeconform/kubeval 做 schema 校验
- Conftest/Kyverno/Gatekeeper 做策略检查
- 镜像扫描、签名校验和 SBOM 检查
发布策略:
- Deployment 滚动更新 + readinessProbe + PDB
- 灰度按副本、流量比例或 header,结合 Service Mesh 或 Gateway API
- 数据库变更与应用发布解耦,先兼容后切换
- 回滚前确认
revisionHistoryLimit、旧镜像和配置都还在 - 发布后观察错误率、延迟、饱和度和业务指标,再扩大范围
资源治理与容量
requests/limits:
- requests 是调度和容量规划依据,limits 是运行时上限
- CPU limit 过紧会节流,内存 limit 过紧会 OOMKilled
- 延迟敏感服务可以只设 CPU requests,不设 CPU limit,避免被节流
- 内存 limit 要覆盖堆、栈、Direct Buffer、page cache 等
QoS:
- Guaranteed:requests=limits,适合关键服务
- Burstable:常见业务
- BestEffort:不设 requests/limits,最容易被驱逐,生产慎用
rightsizing:
- 用 VPA recommend、Prometheus 历史数据、
kubectl top评估 - 定期清理过度申请,避免“申请很大但实际很低”
- LimitRange 设置默认值,避免漏配
- 对批处理和无状态服务分别设计容量模型
扩缩容:
- HPA 处理流量波动,Cluster Autoscaler/Karpenter 处理节点容量
- 设置 maxReplicas 和节点上限,防止成本失控
- 缩容要尊重 PDB、DaemonSet、本地存储和长连接
- 扩容要考虑镜像拉取、CNI IP 耗尽和调度拓扑
升级与变更
版本策略:
- 一次只升一个 minor,先测试集群再生产
- 顺序:控制面 → 节点 → 工作负载
- 关注 Version Skew Policy 和已移除 API
- 升级前备份 etcd,升级后验证 CNI、CoreDNS、Ingress、存储和关键业务
- 保留旧版本镜像和上一版 manifest
变更窗口与回滚:
- 变更前记录基线指标和业务状态
- 明确回滚条件:错误率、延迟、饱和度、业务成功率
- Kubernetes 不支持 minor 降级,回滚主要是应用层和配置层
- 控制面故障时优先恢复 etcd 和 apiserver,再处理工作负载
安全基线
- RBAC 最小权限,禁用匿名访问
- PSA restricted,至少 baseline
- etcd 静态加密 + 审计日志
- Secret 外部化管理,定期轮换
- 镜像签名、SBOM、漏洞扫描
- NetworkPolicy 默认拒绝
- 限制 NodePort/LoadBalancer,入口统一
- 定期 CIS Benchmark、渗透测试和故障演练
成本与容量
- 用 requests 做容量模型,用实际使用做 rightsizing
- 节点池按业务拆分:系统、普通、GPU、内存型
- Spot/抢占实例跑无状态服务,关键服务用按需
- 用 Namespace 标签做成本分摊和预算告警
- 定期清理 Completed Pod、旧 ReplicaSet、未使用 PVC、镜像和快照
- 关注异常增长:副本数、PVC、LoadBalancer、NodePort、日志和指标基数
附录
常用命令
# 集群信息 |