


学习 Namespace 的笔记与 C 语言 Demo 参考书目:《Docker 容器与容器云》
简介
Linux 目前有 8 种 Namespace(本文讲解其中 7 种,time namespace 暂不展开)。
| namespace | 系统调用参数 | 隔离内容 |
|---|---|---|
| UTS | CLONE_NEWUTS | 主机名与域名 |
| IPC | CLONE_NEWIPC | 信号量、消息队列、共享内存 |
| PID | CLONE_NEWPID | 进程编号 |
| Network | CLONE_NEWNET | 网络设备、网络栈、端口等 |
| Mount | CLONE_NEWNS | 挂载点 |
| User | CLONE_NEWUSER | 用户与用户组 |
| Cgroup | CLONE_NEWCGROUP | cgroup 视图(/proc/[pid]/cgroup、cgroupfs) |
namespace 有以下 API:clone()、setns()、unshare()
clone()是 Linux 系统调用 fork()的一种更通用的方式
int clone(int (*child_func)(void *), void *child_stack, int flags, void *arg); |
从 3.8 版本开始,可通过/proc/[pid]/ns 目录查看指向不同 namespace 号的文件,[]中的就是 namespace 号。
ll /proc/$$/ns |
cgroup条目只在 Linux 4.6+ 内核出现,namespace 号以实际机器为准。
设置链接的作用:一旦 link 文件被打开,只要打开的文件描述符存在,则即使该 namespace 下的所有进程都结束,这个 namespace 仍会继续存在,后续的进程仍能加入进来。
通过 setns()加入一个已存在的 namespace
int setns(int fd, int nstype); |
通过 unshare()在原先进程上进行 namespace 隔离,而不用启动新的进程。现代 runc/libcontainer 会同时使用 unshare、clone 和 setns(例如 exec 进入已有 namespace)。
int unshare(int flags); |
fork()系统调用,fork 函数不属于 namespace 的 API,属于 Linux 系统自带的调用。能创建新的进程,并分配资源。fork()调用一次却能返回两次,父进程和子进程各返回一次。可能有三种返回值:
- 在父进程中,返回新创建的子进程的进程 ID
- 在子进程中,返回 0
- 若出现错误,返回一个负值
一个实例代码:
|
编译后输出:
parent process id: 33008 |
父进程退出后,子进程会成为孤儿进程,由 init/subreaper 接管;若子进程先退出而父进程没有 wait/waitpid 回收,则子进程会变成僵尸进程。父进程调用 wait/waitpid 是为了回收僵尸进程,并不是“自己才能正常退出”。
以下是 7 种隔离的具体实现,以下为学习顺序
UTS
简单实现 UTS 隔离,实现代码uts.c
|
编译运行,实现了域名隔离
[root@s1 uts]# gcc -Wall uts.c -o uts |
IPC
简单实现 IPC 隔离,代码与 uts.c 基本一致,只需要添加一个标识位CLONE_NEWIPC
int child_pid = clone(child_main, child_stack + STACK_SIZE, |
先创建一个消息队列
[root@s1 ipc]# ipcmk -Q |
编译后运行 ipc
[root@s1 ipc]# gcc -Wall ipc.c -o ipc |
已实现了 IPC 隔离,在子进程中查看不到原先创建的消息队列
PID
每个 PID namespace 都有自己的计数器,内核为所有 PID namespace 维护一个树状结构,最顶层是系统初始化时创建的,称为 root namespace,新的 Namespace 称为 child namespace。
所属父进程能看到子节点的进程,并可通过信号等方式对子节点的进程产生影响。而子节点不能看到父进程 PID namespace 中的内容。
同样代码仍然使用ipc.c 的,只要添加一个标志位CLONE_NEWPID,保存为pid.c
int child_pid = clone(child_main, child_stack + STACK_SIZE, |
首先查看当前的 shell 的 PID,再运行 pid,查看 shell 的 PID
[root@s1 pid]# echo $$ |
init 进程的 PID 为 1,作为所有进程的父进程,维护一张进程表,检查进程状态,一旦有子进程因父进程的错误变为孤儿进程,init 会收养该子进程,并回收资源,结束进程。
内核为 PID namespace 中的 init 进程赋予了信号屏蔽的特权,若 init 中没有编写处理某个信号的代码,则与 init 同一个 PID namespace 的进程发送给 init 的该信号就会被屏蔽。主要用于防止 init 进程被误杀。
祖先 namespace 向子 namespace 的 init 进程发送信号时,若 init 没有安装对应的处理函数,除SIGKILL和SIGSTOP外的信号会被忽略;发给子 namespace 中其他进程的信号正常投递。SIGKILL和SIGSTOP无法被屏蔽,因此父节点仍有权终止子节点的进程。
当子节点的 init 进程被销毁,即使/proc/[pid]/ns/pid处于挂载或打开状态,导致 namespace 保存下来,但该 namespace 也无法通过setns()或fork()创建进程。
当一个容器中存在多个进程时,容器内的 init 进程可对信号捕获,对子进程做信息保存、资源回收等处理。
在新的 PID namespace 中用ps查看,仍然会看到所有进程。因为与 PID 相关的/proc文件系统(procfs)没有挂载到一个与原/proc不同的位置
[root@newnamespace pid]# ps -a |
挂载文件系统 proc 到/proc
[root@newnamespace pid]# mount -t proc proc /proc |
但此时并没有进行 mount namespace 的隔离,所以该操作实际上影响了 root namespace 的文件系统。因此退出后,仍要重新挂载 proc:mount -t proc proc /proc
调用unshare()创建新的 PID namespace、或setns()加入已有 PID namespace 时,调用者本身不会立即进入新的 PID 视图,之后创建的子进程才会进入并成为 init。因为调用getpid()得到的 PID 由调用者所在的 PID namespace 决定,立即切换 PID 视图会造成进程看到的 PID 变化。
Mount
通过隔离文件系统挂载点对隔离文件系统提供支持,是第一个支持的 Linux namespace。
进程创建 mount namespace 时,会把当前的文件结构复制给新的 namespace,并且子节点中的挂载只影响自身,不影响外部。但也会有例外,因此,2006 年引入的挂载传播解决了该问题,定义了挂载对象(mount object)间的关系:
- 共享挂载(share relationship):若两个挂载对象具有共享关系,则一个挂载对象中的挂载事件会传播到另一个挂载对象,反之亦然。
- 从属关系(slave relationship):若两个挂载对象形成从属关系,则一个挂载对象中的挂载事件会传播到另一个挂载对象,反之不行。从属对象是事件的接受者。
有可能出现的挂载状态:
- 共享挂载(share):传播事件的挂载对象
- 从属挂载(slave):接收传播事件的挂载对象
- 共享/从属挂载(shared and slave):既传播又接收事件的挂载对象
- 私有挂载(private):既不传播也不接收事件的挂载对象
- 不可绑定挂载(unbindable):类似私有挂载,但不允许执行绑定挂载,即这块文件对象不可被复制
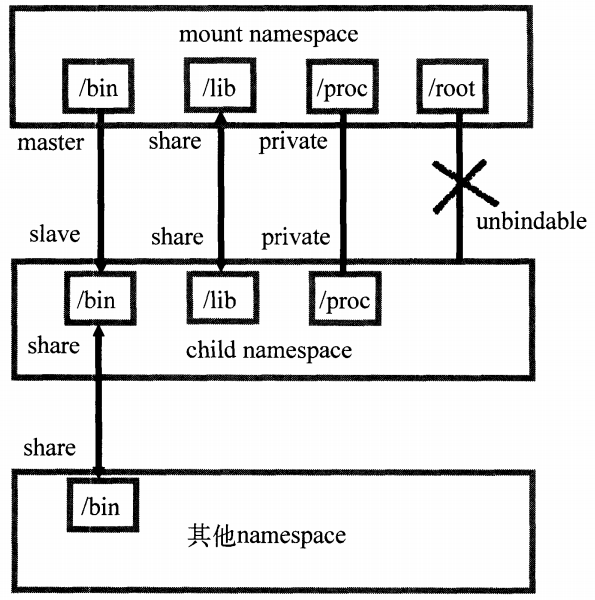
mount提供以上的各种挂载方式:
--make-shared mark a subtree as shared |
代码仍然只需要添加标志位CLONE_NEWNS
|
编译后运行,挂载 CDROM
[root@newnamespace mount]# mount /dev/cdrom /mnt |
Network
网络隔离包括:网络设备、IPv4 和 IPv6 协议栈、IP 路由表、防火墙、/proc/net、/sys/class/net、套接字等。
通过创建 veth pair(虚拟网络设备对)实现容器内外的通信。当创建的 network namespace 被释放时,这个 namespace 中的物理网卡会返回到 root namespace,而不是创建 namespace 的父进程。
在建立好 veth pair 前,新旧 namespace 间通过管道(pipe)通信。以 docker 为例,docker daemon 在宿主进程上创建 veth pair,把一端绑定在 docker0 网桥上,另一端接入新建的 network namespace,在 veth pair 建立完成前,docker daemon 和 init 通过管道通信,直到 init 接收到 docker daemon 发送的 veth 设备信息,然后关闭管道,并启动 eth0。
代码仅需要在 mount.c 上添加标志位CLONE_NEWNET,保存为network.c
int child_pid = clone(child_main, |
编译运行后,查看网络设备,只有一个环回口
[root@s1 network]# ./network |
User
user namespace 主要隔离安全相关的标识符和属性,包括用户(组)ID、root 目录、密钥和特殊权限。user namespace 也类似 PID namespace,是树状结构。
为了能查看用户权限,需要在代码中添加内容。需要导入sys/capability.h,该包需要安装libcap-dev(debian)或libcap-devel(redhat)。
在child_main函数中添加
int child_main(void* args){ |
并在 main 函数添加标志位CLONE_NEWUSER,并且需要删除以前的CLONE标识符,否则可能无法正常显示。
int child_pid = clone(child_main, |
因为添加了 capability 头文件,在编译时需要添加选项-lcap,且要放在源文件之后:gcc -Wall userns.c -o userns -lcap
root:user > ./userns |
子节点的 UID 和 GID 都变为了 65534(默认的),并且用户名变为 nobody。capabilities 为子节点中该用户的权限,已经有所有权限了。65534 表示尚未与外部的 namespace 的用户(组)映射。
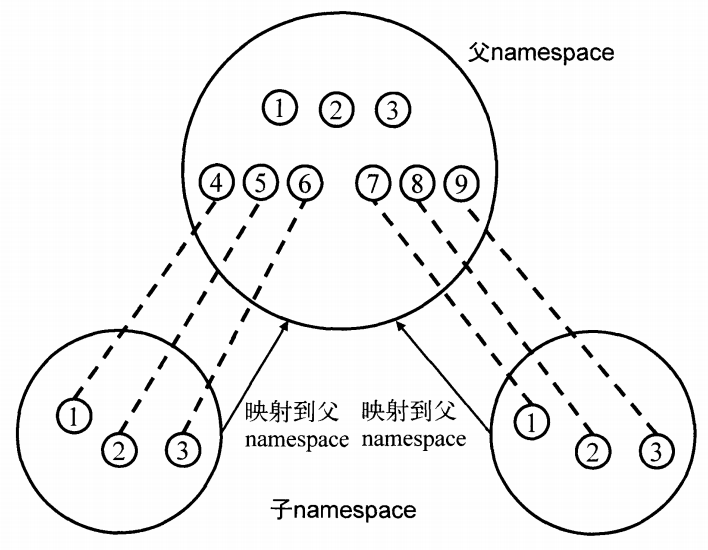
进行用户绑定,通过在/proc/[pid]/uid_map和/proc/[pid]/gid_map写入对应绑定信息即可。
ID-inside-ns ID-outside-ns length |
注:
- 这两个文件各只能写入一次,不允许修改
- 写入进程必须拥有目标 user namespace 中的
CAP_SETUID(uid_map)或CAP_SETGID(gid_map),且必须位于该 namespace 或其父 namespace 中 - 非特权用户做单行映射时,写
gid_map前通常需要先写setgroups=deny;Linux 5.12+ 映射父 namespace 的 UID 0 还涉及CAP_SETFCAP规则 - 第一个字段
ID-inside-ns表示新建的 user namespace 中对应的 UID/GID,第二个字段ID-outside-ns表示外部映射的 UID/GID,length表示映射范围,通常就填 1,表示只映射一个。
创建函数设置 UID 和 GID
void set_uid_map(pid_t pid, int inside_id, int outside_id, int length){ |
然后在 child_main 函数中添加对这两个函数的调用
int child_main(void* args){ |
userns.c完整文件:
|
重新编译执行,结果如下
gutianyi:user > ./userns |
注:非特权单行映射时,执行用户必须与
outside_id对应;以 root 或带CAP_SETUID的父 namespace 运行时可映射任意 ID。
Linux 内核将原来与超级用户相关的高级权限划分为不同的单元,称为 Capability。管理员可独立对特定的 Capability 进行使用或禁用。在 Docker 中同时使用了 user namespace 和 Capability,加强了容器安全性。
Cgroup
cgroup namespace 隔离的是进程看到的 cgroup 视图,而不是资源控制本身。/proc/self/cgroup 的路径始终相对 namespace 根;在 namespace 内重新挂载 cgroupfs 时,挂载根也会是 namespace 根(直接 bind mount 宿主已有的 cgroupfs 挂载则不保证)。
CLONE_NEWCGROUP自 Linux 4.6 引入,cgroup v1 与 v2 都适用,隔离的是 cgroup 视图而非资源限制- cgroup v1:
/proc/self/cgroup每个控制器一行(<id>:<controllers>:<path>),/sys/fs/cgroup下是多个按控制器划分的挂载点 - cgroup v2:unified hierarchy,
/proc/self/cgroup只有一行0::<path>,/sys/fs/cgroup是单个 cgroup2 挂载
namespace 本身不决定读写:只读与否取决于 cgroupfs 的挂载选项。Docker 在 v2 下默认以 ro 挂载 /sys/fs/cgroup,因此容器内通常呈现为以自身 cgroup 为根的只读视图;若以 rw 挂载,子 cgroup 仍可写。
cgroup namespace 的根在创建时确定(即创建进程当时所在的 cgroup),之后不能更改;容器运行时正是先进入容器 cgroup,再创建 cgroup namespace。
它的主要作用是信息隐藏和防误操作:容器内执行 cat /proc/self/cgroup 不会暴露宿主机的完整路径,也降低了误改宿主机 cgroup 层级的风险。但它不是严格的安全边界:已打开的文件描述符、宿主的 bind mount 等方式仍可能绕过;跨 namespace 查看其它进程时,路径中还可能出现 ..。
Docker 从 20.10 起支持 --cgroupns=host / --cgroupns=private:cgroup v2 下默认 private,v1 下默认 host。检查容器内的视图:
# 以下输出以 cgroup v2 + systemd cgroup driver 的宿主机为例 |
cgroup namespace 通常与 mount namespace 搭配(挂载 cgroupfs 需要),在容器里也常和 PID namespace 一起使用:前者只重定 cgroup 视图的根,后者只重定 PID 视图;CPU/内存限制由 cgroup 控制器负责,进程数上限由 pids 控制器负责,都不是 namespace 的职责。