


本文按 Hadoop 生态当前官方文档重写,面向平台运维而不是入门概念。重点讲清 HDFS、YARN、Hive、Spark、Flink、HBase、Kafka、ZooKeeper、Ozone 等组件的运行机制、部署拓扑、日常运维、容量与故障处理。
最后更新:2026-10-22
- 版本基线
- 生态全景
- 集群规划与部署
- HDFS
- YARN
- MapReduce 与 Tez
- Hive
- Spark
- Flink
- HBase
- Kafka
- ZooKeeper
- Ozone
- 数据湖表格式
- 安全
- 监控与容量
- 备份与容灾
- 升级与迁移
- 故障排查
- SRE 方法论
- 企业实践:SRE 视角
- 附录
版本基线
截至 2026-10,主流 Apache 组件版本:
| 组件 | 当前版本 | 说明 |
|---|---|---|
| Hadoop | 3.5.0 | HDFS/YARN/MapReduce/Common |
| Hive | 4.2.1 | 数仓 SQL、HiveServer2、Metastore |
| HBase | 3.0.0 / 2.6.7 | 3.x 新线,2.6.x 仍在维护 |
| Spark | 4.2.0 | 批流一体、Spark SQL |
| Flink | 2.3.0 | 流处理、批处理 |
| Kafka | 4.3.1 | KRaft 模式,4.x 已移除 ZooKeeper 依赖 |
| ZooKeeper | 3.9.6 | Hadoop/HBase 等仍在用 |
| Ozone | 2.1.2 | Hadoop 原生对象存储 |
| Ranger | 2.9.0 | 细粒度权限与审计 |
| Knox | 2.1.0 | 统一网关 |
| Hudi | 1.2.1 | 数据湖表格式 |
| Iceberg | 1.12.0 | 数据湖表格式 |
| Paimon | 2.1.0 | 流批一体湖仓 |
注意:
- CDH 已停止维护,企业发行版转向 CDP 或其他商业发行版;本文以 Apache 社区版为主。
- 组件版本要按发行版兼容矩阵选择,不要只看单个组件最新版。
- Kafka 4.x 只支持 KRaft,不要再规划 ZooKeeper 模式的新集群。
- Hadoop 3.x 是当前主线,2.x 只用于历史系统。
生态全景
Hadoop 生态可以按职责分层:
- 存储:HDFS、Ozone、对象存储、数据湖表格式
- 资源调度:YARN、Kubernetes
- 计算:MapReduce、Tez、Spark、Flink
- SQL/数仓:Hive、Trino/Presto、Impala(第三方)
- NoSQL:HBase
- 消息:Kafka
- 协调:ZooKeeper
- 安全:Kerberos、Ranger、Knox、TLS
- 调度:YARN、Kubernetes、Airflow/DolphinScheduler(第三方)
- 治理:元数据、血缘、权限、审计、质量
典型平台不是“所有组件都装一遍”,而是按业务选:
- 离线数仓:HDFS + YARN + Hive + Spark + Ranger
- 实时链路:Kafka + Flink + HBase/OLAP + 数据湖
- 湖仓:对象存储/Ozone + Iceberg/Hudi/Paimon + Spark/Flink
- 安全网关:Kerberos + Ranger + Knox
集群规划与部署
角色规划
- Master 节点:NameNode、ResourceManager、Hive Metastore、HiveServer2、HBase Master、Kafka Controller(KRaft)、ZooKeeper、Ranger Admin、Knox
- Worker 节点:DataNode、NodeManager、RegionServer、Kafka Broker、Ozone Datanode、Flink TaskManager
- 边缘/网关节点:提交任务、Knox、JDBC、客户端工具
- 监控/管理节点:Prometheus、Grafana、日志、备份
生产建议:
- Master 角色至少 3 节点,按组件拆分,避免所有 Master 挤在一台
- ZooKeeper、JournalNode、Kafka Controller 用奇数副本
- 计算和存储混部要评估 IO、网络和内存争抢
- 边缘节点与核心集群隔离,避免客户端把 Master 打满
高可用
- HDFS:NameNode HA + JournalNode + ZKFC;大规模用 Federation/Router
- YARN:ResourceManager HA + ZooKeeper
- Hive:Metastore 多实例 + 负载均衡;HiveServer2 多实例
- HBase:HMaster HA + RegionServer 多副本
- Kafka:KRaft 多 Controller + 副本因子 ≥ 3
- ZooKeeper:3/5 节点 quorum
- Ranger/Knox:多实例 + 负载均衡
存储与网络
- NameNode/JournalNode 用低延迟本地盘或独立 SSD
- DataNode 用大容量磁盘,JBOD + RAID 取舍要明确
- Kafka 用独立磁盘,避免和 DataNode 抢 IO
- 万兆网络起步,跨机架流量要评估
- 机架感知:HDFS、YARN、HBase、Kafka 都要配置
- 关闭透明大页(THP),按官方建议调内核参数
- 文件句柄、进程数、swap、ulimit 按组件基线调整
操作系统
- 统一发行版和内核版本
- 时间同步(Chrony/NTP)
- DNS 正反向解析
- 关闭不必要的服务
- 统一磁盘挂载、目录、权限
- 用配置管理(Ansible/Puppet)保证一致性
HDFS
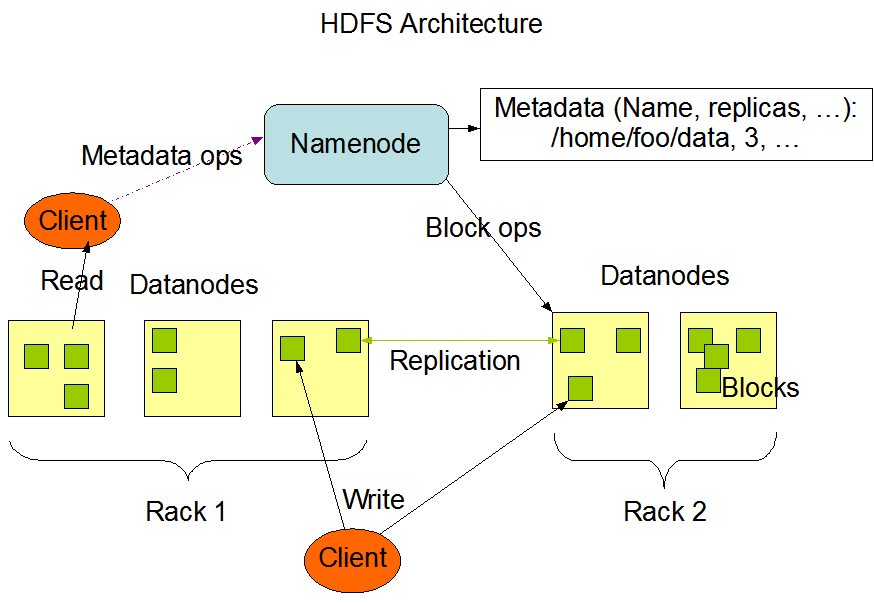
图 1:HDFS 官方架构:NameNode、DataNode、Client
核心机制
- NameNode:管理命名空间、块映射、权限、配额;元数据常驻内存
- DataNode:存储实际数据块,定期心跳和块报告
- JournalNode:HA 下共享 edit log
- ZKFC:监控 NameNode,配合 ZooKeeper 做主备切换
- Block:默认 128MB,副本默认 3
- Rack Awareness:副本跨机架分布,提升容灾能力
读写流程:
- 写:Client 向 NameNode 申请块位置 → 按 pipeline 写 DataNode → 确认
- 读:Client 向 NameNode 获取块位置 → 就近读 DataNode
- NameNode 不参与数据面传输,只负责元数据
日常运维
hdfs dfsadmin -report |
重点:
fsck定期跑,关注 missing blocks、under-replicated blocks- Balancer 在低峰运行,阈值不要一开始设太小
- 磁盘使用率超过 75%–80% 要扩容或清理
- 小文件过多会压垮 NameNode 内存,用 HAR/合并/对象存储缓解
- 开启回收站,设置合理保留时间
- 快照用于误删恢复,不替代备份
HA 与 Federation
- HA:Active/Standby NameNode + JournalNode + ZKFC
- 切换:
hdfs haadmin -getServiceState nn1、-failover - Federation:多个 NameNode 命名空间,Router 提供统一挂载
- ViewFs:客户端挂载表,屏蔽底层命名空间
- 升级时要确认 edit log、镜像和 JournalNode 状态
常见问题
- Safe mode:NameNode 启动或磁盘故障触发;先看 missing/under-replicated blocks,不要直接强制离开
- Missing blocks:检查 DataNode 磁盘、网络、副本;必要时从备份恢复
- DataNode 磁盘满:清理、扩容、调整 reserved space
- NameNode 内存不足:小文件太多或块太多;扩容、合并、Federation
- 写入慢:pipeline 中有慢 DataNode、网络、磁盘故障
YARN
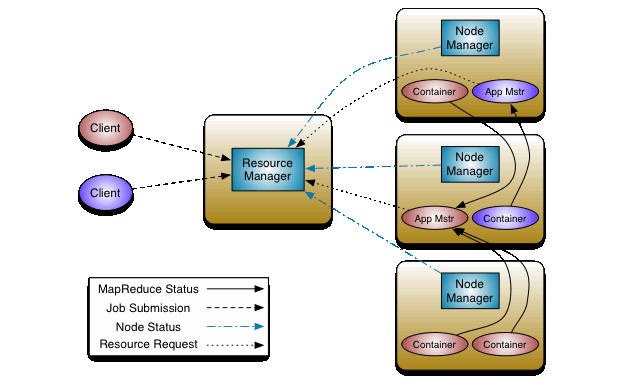
图 2:YARN 官方架构:ResourceManager、NodeManager、ApplicationMaster、Container
核心机制
- ResourceManager(RM):全局资源调度,维护队列和节点
- NodeManager(NM):节点资源管理、Container 启动
- ApplicationMaster(AM):每个应用一个,向 RM 申请资源
- Container:资源分配单元(CPU、内存、可能还有 GPU)
- Scheduler:Capacity Scheduler 或 Fair Scheduler
资源模型:
yarn.nodemanager.resource.memory-mbyarn.nodemanager.resource.cpu-vcoresyarn.scheduler.maximum-allocation-mbyarn.scheduler.minimum-allocation-mb- 队列层级、容量、最大容量、用户限制
日常运维
yarn node -list -all |
重点:
- 队列容量、最大容量、用户/应用限制要按业务规划
- 开启 Node Labels 做资源隔离(GPU、内存型节点)
- 监控 Pending Containers、Reserved、Queue Utilization
- 节点 decommission 要优雅,先停新任务再迁移
- AM 失败会重试,注意
yarn.resourcemanager.am.max-attempts - 大任务要设置合理的 Container 大小和并发
常见问题
- 队列满/Pending:扩容、调队列、限制提交
- Container 被 kill:内存超限、节点不健康、队列限制
- AM 反复失败:应用代码、依赖、权限、资源不足
- NodeManager 不健康:磁盘、本地目录、内存、网络
- RM HA 切换:检查 ZooKeeper、状态存储、网络
MapReduce 与 Tez
- MapReduce 适合大规模批处理,但延迟高
- Tez 用 DAG 优化 Hive/Pig 执行,减少中间落盘
- 关注 shuffle、压缩、推测执行、JVM 重用
- 小文件、数据倾斜、shuffle 落盘是常见性能问题
- 生产上多数 SQL 场景已被 Spark/Tez 替代,MapReduce 更多用于历史作业
Hive
核心机制
- Metastore:元数据服务,后端通常是 PostgreSQL/MySQL
- HiveServer2:JDBC/ODBC 入口
- Warehouse:HDFS/Ozone/对象存储上的数据目录
- ACID 表:支持更新/删除,依赖 compaction
- LLAP(可选):常驻执行服务,提升交互式查询
日常运维
schematool -dbType postgres -info |
重点:
- Metastore 数据库要备份,升级前先做 schema 检查
- Metastore/HiveServer2 多实例,前置负载均衡
- ACID 表要定期 compaction,避免小文件和 delta 膨胀
- 分区表要控制分区数量,避免元数据和 NameNode 压力
- 统计信息(
ANALYZE TABLE)影响执行计划 - Hive 4 升级要检查 Metastore schema、UDF、权限和依赖
常见问题
- Metastore 连接失败:数据库连接、密码、网络、连接池
- ACID 表慢:compaction 积压、delta 文件过多
- 查询慢:统计信息缺失、分区裁剪失效、数据倾斜
- 权限问题:Ranger/SQL Standard 授权、HDFS ACL
- 小文件:合并、调整写入并发、使用 Tez/Spark 控制输出
Spark
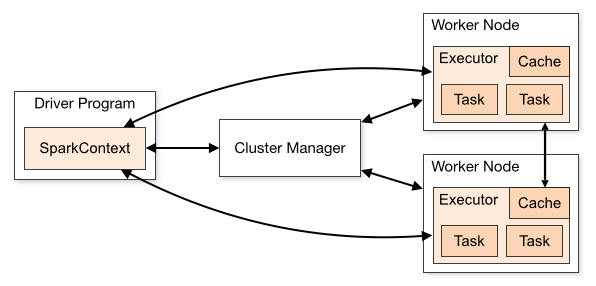
图 3:Spark 官方集群概览:Driver、Cluster Manager、Executor
运行模式
- Spark on YARN:传统 Hadoop 平台常用
- Spark on Kubernetes:云原生环境常用
- Local:开发和调试
核心角色:
- Driver:解析、调度、生成 Task
- Executor:执行 Task、缓存数据
- Cluster Manager:YARN/K8s
- Shuffle Service:YARN 下常用 External Shuffle Service
日常运维
spark-submit \ |
重点:
- 开 AQE(Adaptive Query Execution)处理倾斜和 shuffle 分区
- 开动态资源分配,设置 min/max executor
- Driver/Executor 内存要区分堆内/堆外
- 监控 shuffle spill、GC、Task 失败、Executor 丢失
- History Server 和 event log 要保留,便于复盘
- 大作业错峰,避免打满 YARN 队列
常见问题
- OOM:executor memory、driver memory、广播变量、collect
- 数据倾斜:AQE、加盐、拆分热点 key
- Shuffle 失败:ESS、磁盘、网络、Executor 丢失
- 任务慢:小文件、分区过多、序列化、UDF
- 资源拿不到:队列容量、动态分配上限、集群满
Flink
核心机制
- JobManager:协调、调度、checkpoint
- TaskManager:执行 Task、管理 slot 和状态
- Checkpoint:一致性快照,用于故障恢复
- Savepoint:手动触发的有状态快照,用于升级/迁移
- State Backend:HashMapStateDB/RocksDB
- Watermark:事件时间处理
- 重启策略:fixed-delay、failure-rate、exponential-delay
运行模式
- Flink on YARN
- Flink on Kubernetes(推荐云原生)
- Standalone
日常运维
flink run -c com.example.Job app.jar |
重点:
- Checkpoint 间隔、超时、状态大小要匹配业务
- Savepoint 兼容性要纳入升级流程
- 监控 checkpoint 失败、背压、反压、watermark 延迟
- 状态后端和 RocksDB 要调内存/磁盘
- 大状态作业要评估恢复时间
- Kafka source/sink 的 exactly-once 和事务超时要一起调
常见问题
- Checkpoint 失败:状态太大、HDFS/S3 慢、超时、并发
- 背压:下游慢、算子并行度不足、数据倾斜
- 重启循环:失败率策略、外部依赖、状态不兼容
- Savepoint 恢复失败:算子 UID、状态 schema、版本不兼容
- TaskManager 丢失:资源不足、OOM、节点故障
HBase
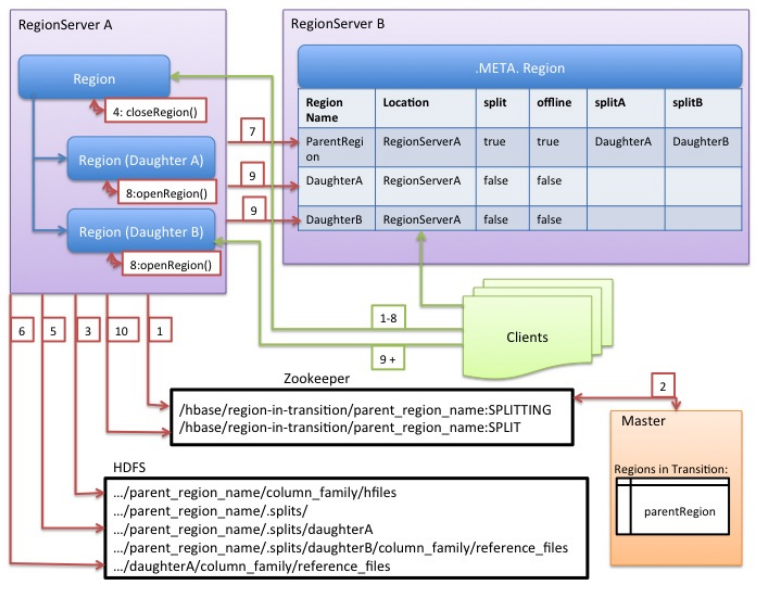
图 4:HBase 官方 Region Split 过程
核心机制
- HMaster:元数据、Region 分配、负载均衡
- RegionServer:读写 Region、MemStore、WAL、BlockCache
- ZooKeeper:集群协调、Master 选举
- HDFS:底层存储
- Region:按 rowkey 范围水平切分
- WAL:写前日志,保证故障恢复
- Compaction:合并 StoreFile,清理过期数据
- Split:Region 达到阈值后分裂
日常运维
hbase shell |
重点:
- Rowkey 设计决定热点和分布,避免单调递增
- 预分区减少初始热点
- 监控 Region 数、StoreFile 数、 compaction 队列、GC
- Major compaction 在低峰执行,避免 IO 风暴
- RegionServer decommission 要优雅迁移
- 快照/导出用于备份,定期恢复演练
- HBase 3.x 升级要检查客户端、协处理器、依赖和 API 兼容
常见问题
- 热点:rowkey 单调、预分区不足、 salting 不当
- RegionServer GC 长暂停:堆过大、MemStore 过多、GC 参数
- Region 过多:split 过碎、表设计不合理
- Compaction 积压:写入量大、磁盘慢、major compaction 频繁
- HBase 无法启动:ZooKeeper、HDFS、WAL、元数据损坏
Kafka
核心机制
- Broker:存储和读写消息
- Controller:KRaft 模式下管理集群元数据
- Topic/Partition:分区是有序日志
- Replica:副本因子,ISR 表示同步副本
- Offset:消费者位点
- Consumer Group:分区分配和 rebalance
Kafka 4.x 只支持 KRaft,ZooKeeper 模式已移除。
日常运维
kafka-topics.sh --bootstrap-server broker:9092 --describe --topic <topic> |
重点:
- 副本因子 ≥ 3,
min.insync.replicas与 acks 一起设计 - 分区数决定并行度,也影响元数据和 rebalance
- 监控 UnderReplicatedPartitions、OfflinePartitions、ISR 收缩
- 磁盘满、网络分区、Controller 故障是常见事故
- 保留策略按业务设置,避免无限增长
- MirrorMaker 2 做跨集群复制
- 升级/迁移要用 KRaft 的 controller quorum
常见问题
- Under-replicated:Broker 慢、磁盘满、网络、ISR 收缩
- Controller 选举频繁:KRaft quorum 不稳定、网络、磁盘
- Consumer lag:消费能力不足、分区倾斜、下游慢
- Rebalance 风暴:消费者频繁上下线、会话超时
- 磁盘满:保留策略、日志段、清理策略
ZooKeeper
核心机制
- Leader/Follower/Observer
- Quorum:写需要多数派确认
- Session:临时节点、心跳、超时
- Watch:一次性通知
- ZNode:数据节点,适合小数据、协调元数据
ZooKeeper 仍被 Hadoop HA、HBase、Knox 等使用;Kafka 4.x 已不再依赖它。
日常运维
zkServer.sh status |
重点:
- 3/5 节点,奇数,跨机架/可用区
- 事务日志和数据目录分离,事务日志用低延迟盘
- 监控 leader 选举、请求延迟、连接数、znode 数
- 定期清理快照和事务日志,避免磁盘满
- 不要存大对象,znode 只放协调数据
- 扩缩容和 reconfig 要谨慎
常见问题
- Leader 频繁选举:GC、磁盘、网络、负载
- 连接数过多:客户端未复用、会话泄漏
- 磁盘满:快照/日志未清理
- Watcher 丢失:客户端重连、一次性 watch
- Quorum 丢失:多数节点不可用
Ozone
核心机制
- Ozone Manager(OM):命名空间和元数据
- Storage Container Manager(SCM):块管理和集群管理
- Datanode:存储容器
- S3 Gateway:S3 兼容接口
- 适合海量小文件、对象存储场景
日常运维
ozone sh volume create /vol1 |
重点:
- OM/SCM HA、Datanode 磁盘和网络
- 容器报告、pipeline、under-replicated
- S3 Gateway 与 Knox/Ranger 集成
- 小文件场景评估 Ozone 与 HDFS 的取舍
- 快照/回收站/配额
数据湖表格式
- Hudi:更新插入、增量拉取、COW/MOR
- Iceberg:快照、隐藏分区、时间旅行、引擎无关
- Paimon:流批一体、LSM、实时湖仓
运维重点:
- Compaction/小文件合并
- Snapshot/Manifest 清理和保留策略
- Catalog(Hive Metastore/Unity/REST)高可用
- 并发写冲突和锁
- 时间旅行与保留期
- 与 Spark/Flink/Trino 的版本兼容
安全
Kerberos
- KDC 高可用,Keytab 生命周期管理
- Principal 命名规范
kinit/klist/kdestroy- 服务端和客户端时间同步
- Keytab 权限最小化,定期轮换
kinit -kt /etc/security/keytabs/hdfs.keytab hdfs/host@EXAMPLE.COM |
授权与审计
- HDFS ACL + Ranger HDFS 策略
- Hive SQL Standard/Ranger 列级、行级过滤
- HBase namespace/table/column family 权限
- Kafka topic/group ACL
- Knox 统一入口、SSO、TLS
- 开启审计日志,接入 SIEM
传输与静态加密
- TLS:HDFS、YARN、Hive、HBase、Kafka、ZooKeeper、Knox
- 证书管理、SAN、轮换
- 静态加密:HDFS Transparent Encryption、Kafka 磁盘加密、对象存储加密
- 密钥独立管理,不要和集群放在一起
监控与容量
监控分层
- 主机:CPU、内存、磁盘、网络、inode、负载
- HDFS:容量、块数、missing/under-replicated、NameNode RPC、GC
- YARN:队列使用、Pending、Container、AM/NM 状态
- Hive:Metastore 连接、HS2 会话、查询延迟、ACID compaction
- Spark:作业时长、shuffle、GC、失败率
- Flink:checkpoint、背压、watermark、重启
- HBase:Region 数、读写延迟、 compaction、GC
- Kafka:ISR、lag、磁盘、Controller
- ZooKeeper:延迟、连接、leader
- 安全:Kerberos 失败、Ranger 拒绝、证书到期
容量
- HDFS 按原始数据 × 副本 × 增长系数规划
- YARN 按 CPU/内存请求和峰值并发规划
- Kafka 按吞吐、保留时间、副本因子规划
- HBase 按 rowkey 分布、读写比例、Region 大小规划
- 预留 20%–30% 余量,避免磁盘写满和队列打满
- 定期做容量复盘和扩容演练
备份与容灾
- HDFS:Snapshot + distcp 到异地/对象存储
- Hive Metastore:数据库逻辑备份 + 定期恢复演练
- HBase:Snapshot/ExportSnapshot + 跨集群复制
- Kafka:MirrorMaker 2 跨集群复制
- Ozone:Snapshot/回收站/跨集群复制
- 数据湖:表快照 + 元数据备份
- Kerberos/Ranger:KDC 数据库、Keytab、策略导出
- 明确 RTO/RPO,定期演练,不要只备份不恢复
升级与迁移
CDH 迁移
- CDH 已停止维护,不能作为新平台选择
- 迁移到 CDP 或 Apache 社区版
- 先盘点组件、版本、依赖、UDF、权限、作业
- 分批迁移,先非核心业务
- 保留双跑和回滚窗口
Hadoop 升级
- 一次一个 minor,先测试集群
- HDFS 支持滚动升级,但 NameNode HA/Federation 要单独验证
- 升级前备份 edit log、镜像、Metastore、Kafka 元数据
- 升级后验证 HDFS、YARN、Hive、HBase、Spark、Flink
- 检查已移除 API 和客户端兼容
组件升级
- Hive 4:Metastore schema、UDF、权限、HiveServer2
- HBase 3:客户端、协处理器、API、依赖
- Spark 4:Scala 版本、依赖、SQL 行为、K8s/YARN 集成
- Flink 2:Savepoint 兼容、状态 schema、连接器
- Kafka 4:KRaft 迁移、客户端协议、ZooKeeper 移除
- ZooKeeper 3.9:滚动升级、快照兼容
故障排查
HDFS
- Safe mode、missing blocks、under-replicated
- NameNode GC/RPC、JournalNode、ZKFC
- DataNode 磁盘、网络、pipeline
YARN
- 队列满、Pending、Container kill
- RM HA、NM 不健康、AM 失败
- 资源模型和调度器配置
Hive
- Metastore 连接、schema、锁
- ACID compaction、小文件
- 统计信息、分区裁剪、数据倾斜
Spark
- OOM、shuffle、倾斜、Executor 丢失
- AQE、动态分配、序列化
- History Server 和 event log
Flink
- Checkpoint、背压、状态、重启
- Savepoint 兼容、连接器
- TM 资源和槽位
HBase
- 热点、GC、Region 过多、compaction
- HMaster/ZooKeeper/HDFS 依赖
Kafka
- ISR、Controller、磁盘、lag、rebalance
- KRaft quorum
ZooKeeper
- Leader 选举、连接数、磁盘、quorum
SRE 方法论
SRE 不是“运维加了监控”,而是用工程方法管理可靠性:把可靠性当作产品特性,用可度量的目标、错误预算和自动化,在“变更速度”和“系统稳定”之间做可解释的取舍。
核心命题
- 可靠性是产品特性:不是运维附属品,要和功能一起设计、一起评审、一起度量。
- 100% 可靠既不可能也不经济:越接近 100%,成本呈指数上升;关键是找到业务可接受的平衡点。
- 用错误预算管理风险:预算充足时可以更激进地发布,预算耗尽时优先修可靠性。
- 用工程手段消除重复劳动:toil 要量化、要自动化,不能靠加班消化。
- 事故是学习机会:复盘对事不对人,输出可执行改进。
- 简单性是可靠性的一部分:系统越复杂,故障面越大,认知负荷越高。
可靠性的数学
可用性九宫格
| 可用性 | 每月不可用 | 每年不可用 |
|---|---|---|
| 99% | 7.2 小时 | 3.65 天 |
| 99.9% | 43.2 分钟 | 8.77 小时 |
| 99.95% | 21.6 分钟 | 4.38 小时 |
| 99.99% | 4.32 分钟 | 52.6 分钟 |
| 99.999% | 26 秒 | 5.26 分钟 |
先问业务:这个服务一年能接受多久不可用?不同答案对应完全不同的架构和成本。
可用性 vs 持久性
- 可用性:现在能不能访问
- 持久性:数据会不会丢
HDFS 副本提升的是持久性和读可用性,但不能保证 NameNode 永远可用;Kafka 副本提升的是分区可用性和持久性,但不能保证客户端不超时。SLO 要分别定义。
错误预算
错误预算 = 1 - SLO |
99.9% 的 30 天窗口:
0.001 × 30 × 24 × 60 = 43.2 分钟 |
错误预算的用途:
- 决定发布节奏
- 决定是否暂停变更
- 决定可靠性投入优先级
- 让开发和运维用同一套语言讨论风险
可靠性的成本曲线
可靠性从 99% 到 99.9% 可能只是加副本和监控;从 99.99% 到 99.999% 可能需要多活、专线、全局调度和大量演练。先确认业务愿意为每一级可靠性付多少钱。
SLI/SLO 设计方法
从用户旅程出发
不要从组件指标出发,先问“用户/业务怎么感知这个服务”:
- 提交一个 Hive 查询,多久返回、是否成功
- 一张核心表,是否在 07:00 前就绪
- 一条实时消息,端到端延迟多少
- 一个 Spark 作业,是否在 SLA 内完成
然后拆到组件 SLI:
- HDFS:NameNode 可用性、读写成功率、p99 延迟
- YARN:RM 可用性、队列等待、应用成功率
- Hive:HS2 可用性、查询成功率、p95 延迟
- Spark:作业成功率、SLA 完成率
- Flink:checkpoint 成功率、端到端延迟
- HBase:读写可用性、p99 延迟
- Kafka:生产/消费可用性、ISR、lag
- ZooKeeper:可用性、延迟、leader 稳定性
SLI 类型
- 可用性:成功请求 / 总请求
- 延迟:p50/p95/p99,按接口/查询类型分
- 吞吐:每秒处理量、作业完成数
- 新鲜度:数据就绪时间、端到端延迟
- 正确性:数据校验通过率、对账差异
- 饱和度:队列、磁盘、连接池、GC
目标怎么定
- 从业务需求倒推,不要拍脑袋
- 参考历史基线,但不要直接复制现状
- 看依赖链:上游只有 99.9%,下游很难做到 99.99%
- 看成本:每提升一个 9,需要多少冗余和人力
- 看可测性:指标采集不到,就不要定这个 SLO
- 先定一个可迭代的目标,按季度 review
窗口与聚合
- 滚动窗口(28/30 天)比日历月更平滑,避免月初重置
- 按服务、租户、关键接口分别看,避免平均值掩盖长尾
- 不要把所有维度混在一起算一个总 SLO
- 关键业务单独 SLO,非关键业务用较低目标
数据平台特有 SLO
- 数据新鲜度:核心表 07:00 前就绪率
- 数据质量:校验通过率、空值率、主键唯一性
- 作业 SLA:关键作业按截止时间完成率
- 查询体验:p95 查询延迟、超时率
- 实时链路:端到端延迟、消费 lag
错误预算政策
| 预算状态 | 动作 |
|---|---|
| > 50% | 正常发布,允许实验 |
| 20%–50% | 谨慎发布,优先稳定性 |
| < 20% | 冻结非必要变更,修复可靠性 |
| 耗尽 | 只允许修复类变更,制定恢复计划 |
政策要提前和业务达成一致,并明确例外审批。
Burn rate 告警
Burn rate = 当前错误率 / 允许错误率。
| 长窗口 | 短窗口 | Burn rate | 动作 |
|---|---|---|---|
| 1h | 5m | 14.4 | 立即呼叫 |
| 6h | 30m | 6 | 高优先级 |
| 3d | 6h | 1 | 工单/容量排查 |
比“错误率 > 1%”更可靠,因为它直接关联错误预算消耗速度。
SLO 反模式
- 定 100% 目标
- 指标不可行动
- 用 SLO 给团队排名
- 只看平均值,不看长尾
- SLO 和业务脱节
- 只定 SLO,不做容量和变更管理
- 预算耗尽后没有政策,只靠吵架
风险与变更
风险分级
- 高风险:升级、迁移、改 HA、改安全、改网络
- 中风险:扩容、调队列、改参数
- 低风险:加监控、改文档、加只读副本
不同风险对应不同审批、验证和回滚要求。
用错误预算调节发布速度
- 预算充足:可以灰度更快、实验更多
- 预算紧张:减少高风险变更,先修可靠性
- 预算耗尽:冻结功能发布,只做修复
这比“一律禁止变更”或“一律放行”更可持续。
变更原则
- 小批量、可回滚、可观测
- 先测试集群,再生产
- 灰度/滚动,不要一次全量
- 变更前后对比 SLO 和关键指标
- 保留回滚窗口和旧版本
- 变更记录可追溯
容量与性能方法论
需求预测
- 历史增长趋势
- 业务计划和大促
- 新业务上线
- 数据保留策略变化
余量
- N+1:坏一个节点不影响服务
- 存储 20%–30% 余量
- 队列 30% 余量
- 网络和 IO 不要打满
Little’s Law
L = λ × W |
并发数 = 到达率 × 平均停留时间。用来估算队列、线程池、连接池和容量。
压测
- 基线:单请求/单作业
- 峰值:业务峰值
- 浸泡:24–72 小时
- 故障:杀节点、磁盘满、网络抖动
- 回归:升级/扩容后复跑
Toil 与自动化
Toil 定义
重复、手动、可自动化、战术性、没有长期价值、随规模线性增长的工作。
50% 规则
SRE 的 toil 不应超过 50% 时间;超过就要排自动化项目,而不是长期加班。
处理顺序
- 消除:这个工作是否必要?
- 简化:能否减少步骤/审批?
- 自动化:脚本 → runbook → 自助 → Operator
- 外包:交给平台/服务台,但要有 SLA
自动化风险
- 自动化错误会放大
- 需要审计、权限、回滚
- 需要测试和灰度
- 需要保留手工兜底
监控与告警方法论
症状 vs 原因
优先告警“用户感知的症状”:
- 请求失败
- 延迟升高
- 数据未按时就绪
- 消费 lag
原因指标(CPU、GC、磁盘)用于排障,不要全部告警。
黄金信号
- Latency
- Traffic
- Errors
- Saturation
数据平台再加:
- 数据新鲜度
- 队列等待
- 作业成功率
- 副本/ISR 健康
告警质量
- 可行动:收到后知道做什么
- 有 owner
- 有 runbook
- 有升级路径
- 低噪音
- 覆盖关键 SLO
On-call
- 轮换、交接、升级
- 告警分级
- 避免疲劳
- 事后复盘告警质量
事故与复盘方法论
事故指挥
- Incident Commander:决策和协调
- Ops Lead:执行恢复
- Comms Lead:对外沟通
- Scribe:记录时间线
先止血
回滚、切流、扩容、隔离、降级,先恢复服务,再找根因。
复盘
- 时间线
- 影响
- 根因和促成因素
- 哪些措施有效/无效
- 改进项、owner、deadline
- 可复用经验
根因往往不是单点,而是“技术 + 流程 + 组织”的共同作用。
可靠性测试
- 混沌工程:定义稳态、提出假设、注入故障、观察、修复
- Game day:定期演练真实故障
- 灾备演练:验证 RTO/RPO
- 压测:验证容量和降级
- 恢复演练:验证备份可用
SRE 组织模型
- 集中式 SRE:统一平台和标准,适合多团队共享基础设施
- 嵌入式 SRE:嵌入业务团队,贴近业务但容易重复建设
- 平台 SRE:把可靠性能力产品化,适合大规模平台
SRE 与 DevOps、平台工程不是替代关系:
- DevOps 是组织方向
- SRE 是可靠性工程专业
- 平台工程把能力做成自助产品
责任与可持续性
- 每个服务有 owner
- on-call 有补偿和轮换
- 错误预算由业务和技术共同认可
- 复盘 action 要跟踪
- 避免“英雄主义”掩盖系统问题
成熟度与反模式
成熟度
- 有监控和 runbook
- 有 SLO 和错误预算
- 有容量模型和变更管理
- 有自动化和混沌演练
- 有平台化自服务和持续优化
反模式
- 把 SRE 当“高级运维”
- 只加监控,不改系统
- SLO 拍脑袋
- 告警越多越好
- 事故只追责,不复盘
- 自动化没有回滚
- 容量靠拍脑袋
- 变更没有灰度
- 用加班替代 toil 治理
企业实践:SRE 视角
Hadoop 平台的 SRE 难点不是“把组件拉起来”,而是让几百个作业、几十个租户在同一个集群上稳定、可预期、可运营。下面按 SRE 的工作方式展开。
平台分层与责任边界
- 基础设施层:主机、网络、存储
- 数据层:HDFS/Ozone/对象存储/表格式
- 计算层:YARN/K8s/Spark/Flink
- 服务层:Hive/HBase/Kafka
- 治理层:元数据、权限、审计、质量、成本
- 接入层:Knox、JDBC、API、门户
责任边界建议:
- 平台 SRE:负责控制面、存储、调度、网关、监控、升级、容量和平台 SLO
- 应用 SRE/数据团队:负责作业、数据模型、业务 SLO、数据质量和成本
- 安全团队:负责 Kerberos、Ranger、证书、审计策略
- 每个服务要有 owner、SLO、runbook、升级路径和 on-call
没有清晰边界,最后会变成“平台背所有作业的锅”。
RACI
| 事项 | 平台 SRE | 数据/应用团队 | 安全 | 业务 |
|---|---|---|---|---|
| 集群/组件升级 | A/R | C | C | I |
| 队列/配额 | A/R | C | I | I |
| 作业失败 | C | A/R | I | I |
| 数据质量 | I | A/R | I | C |
| Kerberos/Ranger | C | C | A/R | I |
| SLO/错误预算 | A/R | C | I | C |
| 事故指挥 | A/R | C | C | I |
| 成本分摊 | R | C | I | A |
A=负责决策,R=执行,C=被咨询,I=被通知。
服务目录
每个平台服务至少登记:
- 服务名、owner、备份 owner
- 级别(P0–P3)
- SLO、依赖、上游/下游
- on-call 轮值、升级路径
- Dashboard、告警、runbook
- 备份方式、RTO/RPO
- 变更窗口和冻结期
- 成本归属(租户/队列/Namespace)
服务目录不是文档摆设,事故时用来快速找到 owner 和依赖。
服务分级与 SLO
先给平台和数据链路分级:
| 级别 | 示例 | 要求 |
|---|---|---|
| P0 | 核心交易/风控/实时链路 | 高可用、强监控、分钟级响应 |
| P1 | 核心数仓、关键报表 | 有 SLO、值班、可回滚 |
| P2 | 内部分析、非实时任务 | 工作时间支持、可延迟 |
| P3 | 实验/临时任务 | 自助、尽力而为 |
SLI/SLO 示例:
| 组件 | SLI | SLO 示例 |
|---|---|---|
| HDFS | NameNode 可用性、读写成功率、p99 延迟 | 99.9% 可用,写入成功率 99.9% |
| YARN | RM 可用性、队列等待时间、应用成功率 | RM 99.9%,P95 等待 < 5 分钟 |
| Hive | HS2 可用性、查询成功率、p95 延迟 | 99.9% 可用,核心查询 p95 < 60s |
| Spark | 作业成功率、p95 时长、SLA 完成率 | 核心作业 99% 按截止时间完成 |
| Flink | Checkpoint 成功率、端到端延迟 | Checkpoint 99%,延迟 p99 < 1s |
| HBase | 读写可用性、p99 延迟 | 99.9% 可用,读 p99 < 20ms |
| Kafka | 生产/消费可用性、ISR、lag | 99.9% 可用,lag < 阈值 |
| ZooKeeper | 可用性、请求延迟、leader 选举 | 99.9% 可用,无频繁选举 |
数据链路还要有数据新鲜度 SLO:
- 核心表每天 07:00 前必须就绪
- 实时链路端到端延迟 ≤ N 秒
- 数据质量校验通过率 ≥ 99%
错误预算:
- 预算充足:允许更激进的变更和扩容
- 预算消耗过快:冻结非必要变更,优先修复可靠性
- 预算耗尽:只允许修复类变更,直到恢复
- 错误预算不是考核工具,是团队和业务之间的决策机制
依赖 SLO 也要看:HDFS 抖动会导致 Hive/Spark/HBase 全部抖动,不能只看单个组件。
错误预算怎么算
以 30 天为窗口:
| SLO | 每月允许不可用 |
|---|---|
| 99.9% | 43.2 分钟 |
| 99.95% | 21.6 分钟 |
| 99.99% | 4.32 分钟 |
计算方式:
不可用预算 = (1 - SLO) × 总时间 |
错误预算要按服务/链路分别计算,不能把 HDFS、YARN、Hive 的预算混在一起。
Burn rate 告警
Burn rate = 当前错误率 / 允许错误率。常用多窗口:
| 长窗口 | 短窗口 | Burn rate | 动作 |
|---|---|---|---|
| 1h | 5m | 14.4 | 立即呼叫,可能耗尽月度预算 |
| 6h | 30m | 6 | 高优先级告警 |
| 3d | 6h | 1 | 工单/容量排查 |
不要用单一静态阈值告警,容易出现“要么太吵、要么漏报”。
数据新鲜度 SLO
数据平台的核心 SLO 往往不是“服务可用”,而是“数据按时就绪”:
- 核心表 07:00 前就绪率 ≥ 99%
- 08:00 前就绪率 ≥ 99.9%
- 实时链路 p99 延迟 ≤ 60s
- 数据质量校验通过率 ≥ 99.5%
按表/主题/租户分别统计,避免平均值掩盖关键表延迟。
依赖 SLO
- HDFS 可用性影响 Hive/Spark/HBase
- YARN 影响 Spark/Flink/MapReduce
- Hive Metastore 影响所有 SQL 引擎
- Kafka 影响实时链路
- ZooKeeper 影响 HDFS HA/HBase/Knox
平台 SLO 要包含依赖链,不能只看单个组件健康。
可观测性
指标
平台层:
- 主机:CPU、内存、磁盘、inode、网络、负载
- HDFS:容量、块数、missing/under-replicated、RPC、GC
- YARN:队列使用、Pending、Container、AM/NM 状态
- Hive:Metastore 连接、HS2 会话、查询延迟、compaction
- Spark:作业时长、shuffle、GC、失败率
- Flink:checkpoint、背压、watermark、重启
- HBase:Region 数、读写延迟、compaction、GC
- Kafka:ISR、lag、磁盘、Controller
- ZooKeeper:延迟、连接、leader
业务/数据层:
- 作业成功率、失败原因分布
- 数据新鲜度、SLA 完成率
- 队列等待、资源利用率
- 租户资源使用和成本
日志与审计
- 组件日志集中采集,保留足够时间
- HDFS/Hive/HBase/Kafka 审计日志接入 SIEM
- 作业日志按 application/job 关联
- 变更、登录、权限变更单独审计
- 日志要能按租户、作业、时间段检索
告警
告警要“可行动”,不要把所有指标都告警:
- 症状告警:可用性、错误率、延迟、数据新鲜度
- 容量告警:磁盘、inode、队列、Kafka lag
- 依赖告警:Kerberos、证书、Metastore、ZooKeeper
- 变更告警:发布后错误率/延迟异常
- 用 burn rate 做 SLO 告警,减少噪音
- 每个告警配 runbook 和 owner
Dashboard
至少四类看板:
- 平台总览:集群健康、容量、关键 SLO
- 组件看板:HDFS/YARN/Hive/Spark/Flink/HBase/Kafka/ZK
- 租户看板:队列、配额、成本、失败作业
- 事故看板:当前告警、进行中事故、变更记录
看板布局
平台总览建议从上到下:
- SLO/错误预算:可用性、延迟、数据新鲜度
- 容量:HDFS 使用率、YARN 队列、Kafka 磁盘、HBase Region
- 组件健康:NameNode/RM/HMaster/Broker/ZK leader
- 租户:Top N 队列、失败作业、等待时间
- 变更:最近发布、升级、配置变更
告警模板
每条告警至少包含:
- 症状和影响范围
- 触发条件和持续时间
- Dashboard 链接
- 排查命令/runbook
- 升级路径和 owner
- 是否需要回滚/切流
告警:HDFS under-replicated blocks > 1000 |
On-call 交接
- 当前告警、进行中事故、近期变更
- 容量水位和已知风险
- 未完成的 action item
- 需要关注的大作业/大促/月结
- 交接记录写进值班系统,不要只靠口头
容量与性能
容量模型
- HDFS:原始数据 × 副本因子 × 增长系数 × 安全余量
- YARN:峰值并发 × 单作业资源 × 队列冗余
- Kafka:吞吐 × 保留时间 × 副本因子
- HBase:数据量 × 副本 × compaction 余量
- 预留 20%–30% 余量,避免磁盘写满和队列打满
- 每季度做容量复盘和扩容演练
计算示例
HDFS
原始磁盘 1000TB,副本 3,目标使用率 75% |
还要扣掉 reserved space、快照、回收站和临时数据。
YARN
100 节点 × 128GB = 12.8TB |
vcores 同理:100 × 32 = 3200,保留 10% -> 2880。
Kafka
吞吐 50MB/s,保留 3 天,副本 3,压缩比 0.5 |
再留 30% 余量,并考虑副本重建、滚动重启和突发流量。
HBase
- Region 大小 10–20GB
- 单 RegionServer 100–200 个 Region
- 堆内存、MemStore、BlockCache 比例按读写模型调
- 预留 compaction 和 split 的 IO 余量
压测计划
- 基线:单作业、单查询、单 Topic 的延迟和吞吐
- 峰值:业务峰值并发,观察队列等待和 P99
- 浸泡:持续 24–72 小时,观察泄漏、GC、磁盘增长
- 故障:压测中杀节点/磁盘满/网络抖动,验证降级和恢复
- 回归:每次升级/扩容后复跑关键基线
性能
- 新业务上线前做压测和基准测试
- 关注 HDFS 小文件、YARN 队列等待、Spark shuffle、HBase 热点、Kafka 分区倾斜
- 建立组件基线:IOPS、吞吐、延迟、GC、CPU
- 变更前后对比基线,避免“慢一点”累积成事故
- 大作业错峰,关键作业设置优先级和预留资源
变更管理
变更分类:
- 常规变更:加队列、调参数、扩容
- 高风险变更:升级、迁移、改 HA、改安全
- 紧急变更:故障修复
原则:
- 所有配置进 Git,禁止手工漂移
- 变更前 diff、评审、备份、回滚方案
- 高风险变更先在测试集群验证
- 灰度/滚动升级,观察 SLO 和关键作业
- 设置变更窗口和冻结期,避开大促/月结
- 变更后记录时间线、影响和验证结果
变更单模板
- 变更目的和影响范围
- 涉及组件/版本/配置
- 前置检查:容量、副本、备份、证书
- 执行步骤和命令
- 验证步骤:SLO、关键作业、数据一致性
- 回滚步骤和回滚条件
- 观察窗口和负责人
升级 runbook
- 备份:etcd/Metastore/NameNode 元数据/Kafka 元数据
- 检查兼容矩阵和已移除 API
- 测试集群演练
- 停新作业/进入维护窗口
- 升级控制面组件
- 滚动升级 worker
- 验证 HDFS/YARN/Hive/Spark/Flink/HBase/Kafka
- 恢复作业,观察 24–72 小时
- 保留回滚窗口
回滚条件
- 关键 SLO 持续跌破
- 数据丢失或不可读
- 作业大面积失败
- 安全策略失效
- 回滚窗口内无法定位根因
回滚不是失败,硬撑才是。
事故管理
分级
| 级别 | 影响 | 首次响应 | 更新频率 | 升级 |
|---|---|---|---|---|
| SEV1 | 平台级不可用、数据丢失、安全事件 | 5 分钟 | 15 分钟 | 技术负责人/业务负责人 |
| SEV2 | 核心组件严重降级、核心 SLA 风险 | 15 分钟 | 30 分钟 | 平台负责人 |
| SEV3 | 部分租户/作业受影响,有绕行方案 | 30 分钟 | 2 小时 | 值班负责人 |
| SEV4 | 轻微问题 | 工作时间 | 按需 | 工单 |
沟通模板
【现状】HDFS NameNode Active 切换失败,Hive/Spark 读取大面积超时 |
角色
- Incident Commander:决策、协调、对外沟通
- Ops Lead:执行恢复
- Comms Lead:同步业务和用户
- Scribe:记录时间线
流程
- 发现与确认
- 分级、拉群、指定 IC
- 先止血:回滚、切流、扩容、隔离
- 定位根因
- 恢复并验证
- 复盘和改进项跟踪
复盘
- 对事不对人,关注系统、流程、工具
- 时间线、影响、根因、促成因素
- 哪些措施有效/无效
- 改进项、负责人、期限
- 可复用的 runbook 和监控
复盘模板:
标题:2026-10-20 HDFS NameNode 切换失败 |
Action item 要有 owner、deadline、验证方式和跟踪看板;没有跟踪的复盘等于没做。
故障演练与混沌
定期做 game day,不要等真实故障:
| 故障 | 验证点 |
|---|---|
| NameNode Active 宕机 | ZKFC 切换、客户端重试 |
| DataNode 磁盘故障 | 副本恢复、balancer |
| YARN RM 宕机 | HA 切换、作业恢复 |
| Hive Metastore 宕机 | HS2 重连、查询失败率 |
| HBase RegionServer 宕机 | Region 迁移、恢复时间 |
| Kafka Broker/Controller 宕机 | ISR、leader 选举、lag |
| ZooKeeper Leader 宕机 | quorum、选举时间 |
| 磁盘满/网络分区 | 告警、降级、恢复 |
演练前定义稳态指标,演练后复盘并更新 runbook。
NameNode 切换
- 前置:HA 健康、JournalNode ≥ 3、ZK 正常、无 missing blocks
- 步骤:
hdfs haadmin -getServiceState nn1→-failover→hdfs dfs -ls /→hdfs fsck / - 成功标准:切换时间可接受、客户端自动重连、无数据丢失
- 中止条件:JournalNode 异常、切换后无法写入
DataNode 故障
- 停一个 DataNode 或拔盘
- 观察 under-replicated blocks、副本恢复时间
- 恢复后跑
hdfs balancer,确认分布均衡
ResourceManager 切换
yarn rmadmin -getServiceState rm1yarn rmadmin -failover rm1 rm2- 验证
yarn application -list、新作业提交
HBase RegionServer 故障
- 停一个 RegionServer
- 观察 Region 迁移、恢复时间、读写错误率
- 恢复后
hbase hbck、balancer
Kafka Controller/Broker 故障
kafka-metadata-quorum.sh --bootstrap-server ... describe --status- 停 Broker/Controller,观察 ISR、leader 选举、lag
- 验证生产/消费恢复
ZooKeeper Leader 故障
zkServer.sh status- 停 Leader,观察选举时间和 quorum
- 验证 HDFS/HBase/Knox 依赖恢复
演练管理
- 提前通知业务,设置回滚点
- 只改一个变量,避免同时注入多个故障
- 记录时间线、指标、恢复动作
- 演练后更新 runbook 和监控
Toil 与自动化
常见 toil:
- 手工加队列/配额
- 磁盘清理、balancer、compaction
- 证书/Keytab 轮换
- 重启组件、处理告警
- 作业失败重跑和审批
- 容量报表和成本统计
治理方式:
- 量化 toil 占比,纳入团队容量
- 高频、易错、规则明确的任务优先自动化
- 用 Ansible/Terraform/Operator 做标准化
- 自助门户处理配额、队列、权限申请
- Runbook 自动化,减少夜间手工操作
- 自动化要有审计、回滚和权限控制
量化 Toil
Toil 占比 = 每周 toil 小时 / 每周总工时 |
目标:
- 平台 SRE:toil < 30%–40%
- 应用 SRE:toil < 20%
- 超过阈值就要排自动化项目,而不是长期加班
自动化优先级
按“频率 × 疼痛 × 风险降低 / 实现成本”排序:
| 任务 | 频率 | 疼痛 | 风险 | 优先级 |
|---|---|---|---|---|
| 证书/Keytab 轮换 | 高 | 高 | 高 | P0 |
| 磁盘清理/balancer | 高 | 中 | 中 | P1 |
| 队列/配额申请 | 高 | 中 | 低 | P1 |
| 作业失败重跑 | 高 | 高 | 中 | P1 |
| 容量报表 | 中 | 低 | 低 | P2 |
自动化阶梯
- 脚本化:把手工步骤写成可重复脚本
- Runbook 自动化:参数化、加校验、加回滚
- 自助化:门户/API,让用户自己完成
- Operator/控制器:持续 reconcile,自动修复
不要跳过 1–2 直接做 4,否则故障时没人能手工兜底。
多租户与公平性
- YARN 队列按业务/团队划分,设置 capacity/max-capacity
- 用 user-limit、application limit 防单用户打满
- 资源标签隔离 GPU/内存型节点
- HDFS 配额、目录权限、Ranger 策略
- Hive 数据库/表权限、行/列过滤
- Kafka topic/group ACL、配额
- 识别 noisy neighbor:队列等待、磁盘 IO、NameNode RPC
- 按租户做成本分摊和账单
YARN 队列示例
<property> |
设计原则:
- 生产队列有保底容量,避免被临时任务挤占
- adhoc 允许借用,但设置 maximum-capacity
- 关键作业用优先级/预留,不要只靠队列
- 队列层级不要过深,便于理解和排障
配额示例
- HDFS:租户目录 100TB,快照和回收站单独计算
- Hive:租户数据库 50TB,限制分区数和临时表
- Kafka:租户生产 10MB/s、消费 20MB/s
- YARN:单用户最大 30% 队列容量
Noisy Neighbor 识别
| 症状 | 检查 | 缓解 |
|---|---|---|
| 其他租户作业变慢 | 队列等待、Container 抢占 | 队列隔离、上限 |
| NameNode RPC 升高 | 小文件数、目录数 | 合并、配额、Federation |
| 磁盘 IO 高 | DataNode/Kafka 磁盘 | 分开磁盘、限流、分层 |
| 网络打满 | 跨机架流量、shuffle | 机架感知、限速 |
| HBase 读延迟升高 | Region 热点、GC | 预分区、rowkey 设计 |
数据可靠性与灾备
- 明确 RTO/RPO,按业务分级
- HDFS:Snapshot + distcp 到异地/对象存储
- Hive Metastore:数据库逻辑备份 + 恢复演练
- HBase:Snapshot/ExportSnapshot + 跨集群复制
- Kafka:MirrorMaker 2
- Ozone:Snapshot/跨集群复制
- 数据湖:表快照 + 元数据备份
- Kerberos/Ranger:KDC、Keytab、策略导出
- 每季度做恢复演练,验证备份可用
RTO/RPO 分级
| 级别 | RPO | RTO | 示例 |
|---|---|---|---|
| P0 | 0–5 分钟 | 30 分钟 | 实时交易、风控 |
| P1 | 1 小时 | 2 小时 | 核心数仓 |
| P2 | 24 小时 | 24 小时 | 内部报表 |
| P3 | 按需 | 按需 | 实验数据 |
备份矩阵
| 数据 | 方式 | 频率 | 保留 |
|---|---|---|---|
| HDFS | Snapshot + distcp | 每日/每周 | 7–30 天 |
| Hive Metastore | 数据库逻辑备份 | 每日 | 30 天 |
| HBase | Snapshot/ExportSnapshot | 每日 | 7–30 天 |
| Kafka | MirrorMaker 2 | 持续 | 按业务 |
| Ozone | Snapshot/跨集群复制 | 每日 | 按业务 |
| 数据湖表 | 表快照 + 元数据 | 每日 | 按业务 |
| Ranger | 数据库/策略导出 | 每日 | 30 天 |
恢复演练
- 选一个非生产环境或隔离命名空间
- 按 runbook 恢复数据
- 校验行数、校验和、分区、权限
- 记录实际 RTO/RPO
- 更新 runbook 和容量模型
- 清理恢复环境
恢复失败通常不是备份文件坏了,而是权限、版本、元数据、网络或步骤缺失。
成本与效率
- 冷热分层:HDFS/Ozone/对象存储
- 压缩、列式存储、小文件合并
- 计算资源弹性,避免长期闲置
- 生命周期管理和数据归档
- 按团队/业务做成本可视化
- 关注单位成本:每 TB、每作业、每查询
- 定期清理无用副本、临时表、过期快照
单位成本
单位成本 = (存储 + 计算 + 网络 + 软件/支持) / 业务量 |
常用口径:
- 每 TB 月成本
- 每千作业成本
- 每万次查询成本
- 每租户/团队成本
没有单位成本,就无法判断“扩容”是业务增长还是浪费。
优化杠杆
| 杠杆 | 影响 | 风险 |
|---|---|---|
| 冷热分层 | 存储成本下降 | 访问延迟、迁移成本 |
| 压缩/列式 | 存储和 IO 下降 | CPU 增加、格式兼容 |
| 小文件合并 | NameNode 和查询改善 | 合并任务占用资源 |
| 降低副本 | 存储下降 | 可靠性下降,需评估 |
| 弹性计算 | 闲置下降 | 调度复杂、冷启动 |
| 生命周期清理 | 存储下降 | 误删风险 |
| 队列配额 | 防止独占 | 业务可能受限 |
成本分摊
给资源打标签:
- HDFS 目录:租户/业务/环境
- YARN 队列:团队/项目
- Hive 数据库:业务域
- Kafka topic:业务/团队
- 对象存储 bucket:租户
每月出账单,按“谁使用、谁付费”推动优化。
SRE 组织与协作
- 平台 SRE 和应用/数据 SRE 分工明确
- On-call 轮换、交接、升级路径和补偿
- 每周看 SLO、错误预算、容量和事故
- 复盘 action item 要有 owner 和 deadline
- 建立知识库、runbook、故障案例库
- 把平台当产品,度量采用率、上手时间和满意度
On-call 体系
- Primary:第一响应,5–15 分钟
- Secondary:Primary 未响应或需要升级时介入
- Escalation:组件 owner、平台负责人、安全/网络
- 交接:告警、事故、变更、风险、未完成 action
- 轮换:避免长期一人值班,提供补偿和调休
- 演练:新成员先 shadow,再独立值班
会议节奏
- 每周:SLO、错误预算、事故、容量、变更
- 每月:成本、租户配额、容量趋势
- 每季度:灾备演练、混沌演练、架构评审
- 事故后:复盘和 action 跟踪
错误预算政策
| 预算状态 | 动作 |
|---|---|
| > 50% | 正常发布,允许实验 |
| 20%–50% | 谨慎发布,优先稳定性 |
| < 20% | 冻结非必要变更,修复可靠性 |
| 耗尽 | 只允许修复类变更,复盘并制定恢复计划 |
政策要提前和业务达成一致,事故时才不会扯皮。
平台产品指标
- 采用率:使用黄金路径的团队比例
- 上手时间:新服务从创建到上线的时间
- 自助率:无需工单完成的比例
- 满意度:开发者 NPS/反馈
- 失败率:平台导致的作业失败比例
成熟度路线
- 可运行:组件部署、基础监控、手工运维
- 可观测:指标/日志/告警、runbook、值班
- 可度量:SLO、错误预算、容量模型、变更管理
- 可自愈:自动化、自服务、混沌演练、成本优化
不要跳级。没有可观测性和 runbook,直接上自动化会把故障放大。
| 阶段 | 退出标准 |
|---|---|
| 可运行 | 关键组件 HA、备份可用、基础监控、基本 runbook |
| 可观测 | SLO/看板、可行动告警、值班、事故流程、复盘 |
| 可度量 | 错误预算、容量模型、变更管理、成本分摊、容量复盘 |
| 可自愈 | 自动化、自服务、混沌演练、错误预算政策、持续优化 |
附录
常用端口
| 组件 | 端口 |
|---|---|
| HDFS NameNode | 8020/9870 |
| DataNode | 9864/9866 |
| YARN RM | 8032/8088 |
| NodeManager | 8042 |
| Hive Metastore | 9083 |
| HiveServer2 | 10000/10002 |
| HBase Master | 16000/16010 |
| RegionServer | 16020/16030 |
| Kafka | 9092/9093 |
| ZooKeeper | 2181/2888/3888 |
| Ozone OM | 9862 |
| SCM | 9860 |
| Ranger Admin | 6080 |
| Knox | 8443 |
常用命令速查
# HDFS |