


本文基于 Kubernetes v1.37(当前 v1.37.1,维护 1.37/1.36/1.35)官方文档重写,讲清 Pod 网络、Service 数据面、Ingress/Gateway、DNS、NetworkPolicy、CNI 与排障。旧笔记只有 80 多行且停留在 Docker/Flannel 时代,不再作为操作依据。
最后更新:2026-10-23
网络模型
Kubernetes 的网络模型有三条基本要求:
- 每个 Pod 有自己的 IP
- Pod 之间可以直接通信,不需要 NAT
- 节点上的 agent(kubelet、kube-proxy)能和该节点上的所有 Pod 通信
Pod 到 Pod 通常是扁平网络;Pod 访问 Service 时,由节点上的转发规则把虚拟 IP 转成某个 Pod IP;出集群流量是否 NAT 取决于 CNI 的 masquerade 配置。
两个关键网段:
- Pod CIDR:Pod IP 的地址范围,通常每个节点分配一个子网
- Service CIDR:Service 虚拟 IP 的地址范围,不与 Pod CIDR 重叠
kubeadm 创建集群时用 --pod-network-cidr 指定 Pod 网段;kube-apiserver 用 --service-cluster-ip-range 指定 Service 网段。
数据包路径
理解 Kubernetes 网络,最有效的方法不是背组件,而是把一个包从源到目的走一遍,观察 IP、端口、netns、路由、NAT、conntrack 在哪里变化。
四种典型路径
1. 同节点 Pod → Pod
Pod A netns |
- 源/目的 IP 都是 Pod IP,不做 NAT。
- 经过 veth pair 和节点网桥(或三层路由)。
- 受 NetworkPolicy、CNI 的 eBPF/iptables 规则影响。
- 同节点也可能走 overlay 逻辑,但通常被 CNI 优化为本地转发。
2. 跨节点 Pod → Pod
Pod A ──► 节点 A veth/网桥 ──► 节点 A 物理网卡 |
- underlay:Pod IP 在底层网络可路由,性能最好,但要求网络团队配置路由/BGP。
- overlay:外层封装,跨子网方便,但增加封装头、降低 MTU,并可能触发分片/PMTUD 问题。
- 跨节点路径是 NetworkPolicy 最容易出现“同节点通、跨节点不通”的地方。
3. Pod → ClusterIP
Pod A |
关键点:
- ClusterIP 是虚拟地址,通常不绑定在任何网卡上,也没有进程监听。
kube-proxy只负责写转发规则,不在数据路径上转发每个包。- 回包依靠 conntrack 做反向 NAT,源 Pod 看到的是 Service VIP,而不是后端 Pod IP。
- 默认
internalTrafficPolicy: Cluster会选择所有节点上的 Endpoint;Local只选本节点。
4. 外部 → NodePort / LoadBalancer
客户端 |
externalTrafficPolicy: Local 的代价是:节点没有该 Service 的 Pod 时,流量直接失败;好处是源 IP 保留、少一跳。它常和 DaemonSet 网关、节点本地负载均衡一起使用。
包在路上被改了什么
| 场景 | 目的 IP | 源 IP | 端口 | NAT/conntrack |
|---|---|---|---|---|
| 同节点 Pod→Pod | Pod B | Pod A | 不变 | 无 |
| 跨节点 Pod→Pod | Pod B | Pod A | 不变 | 通常无(overlay 只加封装) |
| Pod→ClusterIP | 先 VIP,后 Pod B | Pod A | 目标端口可能变 | DNAT + 反向 NAT |
| 外部→NodePort(Cluster) | 先 NodeIP,后 Pod B | 可能 SNAT 成节点 IP | 可能变 | DNAT + SNAT |
| 外部→NodePort(Local) | 先 NodeIP,后本节点 Pod | 保留客户端 IP | 可能变 | DNAT |
| Pod→外部 | 外部 IP | 可能 SNAT 成节点 IP | 可能变 | masquerade |
责任边界
| 组件 | 负责 | 不负责 |
|---|---|---|
| CNI | Pod 建网、IPAM、veth/路由/overlay、部分 NetworkPolicy | Service VIP、Ingress |
| kube-proxy / eBPF | Service VIP 到 Endpoint 的转发规则 | Pod IP 分配、L7 路由 |
| CoreDNS | 服务发现域名解析 | 流量转发 |
| Ingress/Gateway | L7 入口路由、TLS 终止 | Pod 网络、Service 负载均衡 |
| NetworkPolicy | L3/L4 允许/拒绝 | 身份认证、L7 授权 |
排障时先判断“包现在应该在哪一层”,再看这一层的规则和计数器。盲目抓包通常只能看到结果,看不到决策。
Pod 网络与 CNI
CNI(Container Network Interface)是容器运行时和网络插件之间的标准接口。kubelet 创建 Pod 沙箱后,调用 CNI 插件完成:
- 创建 veth pair
- 给 Pod 分配 IP
- 配置路由
- 把 Pod 接入节点网桥或 overlay
- 安装 NetworkPolicy 规则(如果 CNI 支持)
CNI 规范的基本操作是 ADD、DEL、CHECK、VERSION,部分插件还支持 GC、STATUS。
常见实现:
- Flannel:简单,常用 VXLAN 或 host-gw,本身不执行 NetworkPolicy
- Calico:BGP 三层路由为主,也支持 IPIP/VXLAN overlay;用 iptables 或 eBPF 执行 NetworkPolicy
- Cilium:eBPF 数据面,支持 kube-proxy replacement、NetworkPolicy、Hubble 可观测性和 Gateway API
- Antrea:基于 Open vSwitch,支持 NetworkPolicy 和流量可视化
- Canal:Flannel + Calico 策略
节点内通信通常通过 veth pair + 网桥/路由;跨节点通信由 CNI 决定走 underlay 路由还是 overlay 隧道。
CNI 调用链与 IPAM
Pod 创建时,kubelet 通过 CRI 让容器运行时创建 sandbox(pause 容器),然后调用 CNI:
kubelet |
CNI 规范的核心操作:
| 操作 | 作用 |
|---|---|
ADD |
创建网络、分配 IP、配置路由 |
DEL |
回收 IP、删除 veth/规则 |
CHECK |
检查网络配置是否符合预期(可选) |
GC |
清理孤儿资源(可选) |
VERSION |
协议版本协商 |
CNI 本身只负责“把网络配好”,不负责调度、Service、Ingress。NetworkPolicy 是否生效,取决于 CNI 是否实现了策略执行;Flannel 只做连通性,不执行 NetworkPolicy。
IPAM
Pod IP 通常来自节点分配到的 Pod CIDR:
- kube-controller-manager 用
--allocate-node-cidrs给节点分配podCIDR。 --cluster-cidr是集群 Pod 总网段,--node-cidr-mask-size决定每个节点的子网大小。- CNI 的 IPAM 插件(host-local、Calico、Cilium 等)在节点子网内分配具体 IP。
要保证:
- Pod CIDR、Service CIDR、节点网络、VPC/IDC、VPN 网段不重叠。
- 每个节点子网足够容纳最大 Pod 数(还要预留滚动更新和临时 Pod)。
- IPAM 回收正常;Pod 删除后 IP 不应长期泄漏。
hostNetwork 与特殊 Pod
hostNetwork: true 的 Pod 直接使用节点网络命名空间:
- 没有独立 Pod IP,端口与节点共享,容易冲突。
- 不走常规 CNI 重定向,NetworkPolicy/Service mesh 行为可能与普通 Pod 不同。
- 常见于 CNI、kube-proxy、Ingress Controller、监控 agent;部署时要限制端口和调度范围。
Pod 网络命名空间共享
同一个 Pod 内的容器共享 network namespace,因此:
- 容器之间通过
localhost通信。 - 不能有两个容器监听同一个
IP:Port。 - 共享的是网络命名空间,不是文件系统或进程空间。
Service 网络
为什么需要 Service
Pod IP 会随重建变化,Service 提供稳定的虚拟 IP 和 DNS 名称,并通过 selector 选择后端 Pod。
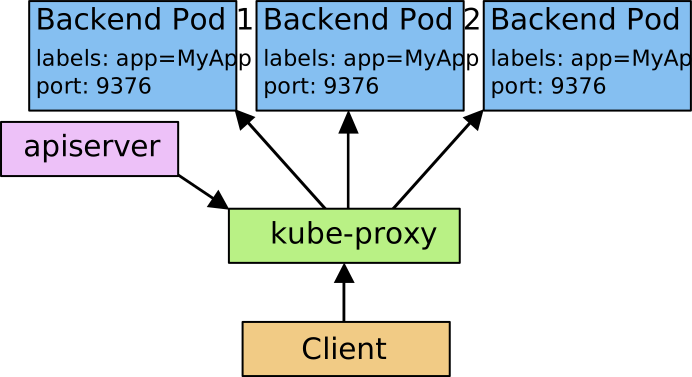
图 1:Service 通过 selector 选择一组 Pod
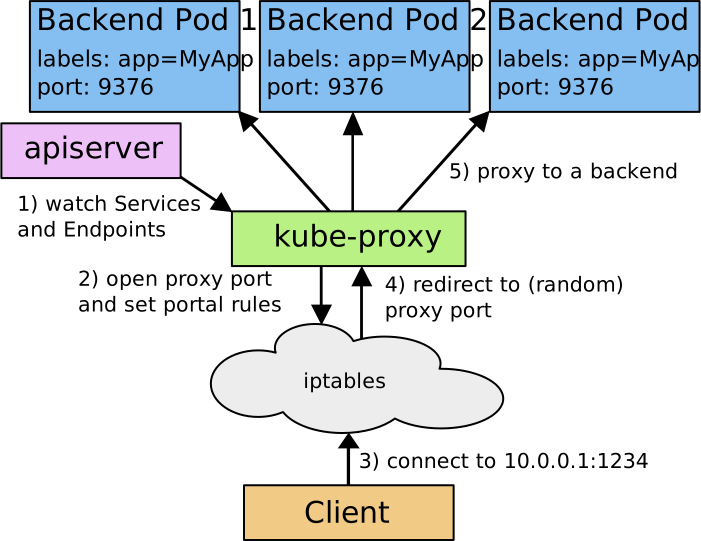
图 2:Service 的虚拟 IP、端点与转发
类型
ClusterIP:集群内虚拟 IP,默认类型NodePort:在每个节点监听端口,默认 30000-32767LoadBalancer:云厂商负载均衡或 MetalLBExternalName:DNS CNAME,不做转发Headless(clusterIP: None):不分配 VIP,返回 Pod IP,StatefulSet 常用
apiVersion: v1 |
port 是 Service 端口,targetPort 是容器端口。多个端口时 name 必须唯一。
类型细节
- Headless(
clusterIP: None):不分配 VIP,DNS 直接返回 Pod IP。适合 StatefulSet、客户端自己做负载均衡/分片、需要感知每个 Pod 的场景。没有 VIP 就没有 kube-proxy DNAT;客户端连接的是具体 Pod,失败重试和连接管理要自己做。 - ExternalName:只创建 CNAME,不做代理、不做 DNAT。客户端必须能解析该 CNAME;NetworkPolicy 也看不到“Service 层”的流量。
- NodePort:在每个节点开放端口(默认 30000–32767)。可以显式指定
nodePort,但冲突时 Service 创建失败。NodePort 是“节点入口”,不是给集群内服务用的首选。 - LoadBalancer:由云控制器或 MetalLB 分配外部 IP。
loadBalancerClass用于多实现共存(设置后不可修改);allocateLoadBalancerNodePorts: false可以避免创建 NodePort(取决于实现支持)。.status.loadBalancer.ingress[].ipMode是控制器写入的状态(VIP/Proxy),不是用户配置项,用来描述 LB IP 的转发行为,影响源 IP 和健康检查的解读。 - 无 selector 的 Service:不会自动生成 EndpointSlice,需要手动创建 EndpointSlice/Endpoints 指向外部地址;适合把外部数据库、旧系统纳入 Service DNS。
sessionAffinity: ClientIP 可以让同一客户端 IP 固定到同一个后端,默认超时 3 小时(sessionAffinityConfig.clientIP.timeoutSeconds)。它基于连接/源 IP,不是基于用户身份;NAT 后大量客户端可能共享一个源 IP,导致倾斜。
EndpointSlice
Service 的后端由 EndpointSlice 表示:
kubectl get endpointslices -l kubernetes.io/service-name=web |
新实现使用 discovery.k8s.io/v1 EndpointSlice。旧的 Endpoints API 已废弃,不支持双栈,规模大时会被截断。
EndpointSlice 的三个条件:
| 条件 | 含义 |
|---|---|
serving |
端点可以接收流量(Pod ready 且未终止) |
terminating |
Pod 正在删除,但可能仍有连接 |
ready |
等价于 serving && !terminating;publishNotReadyAddresses 时恒为 true |
滚动更新时,kube-proxy 通常忽略 terminating 端点,但如果所有端点都在终止,可能继续把流量发给 serving + terminating 的端点,避免服务中断。这也是“Pod 已经 Terminating,但仍有少量流量”的正常原因。
其他细节:
- 一个 EndpointSlice 默认最多 100 个端点,超出会拆成多个切片;大规模服务不要假设只有一个 EndpointSlice。
addressType可以是IPv4、IPv6或FQDN。publishNotReadyAddresses: true让未就绪 Pod 也进入 DNS/EndpointSlice,StatefulSet 集群引导常用;但也会把未就绪实例暴露给客户端。- 无 selector 的 Service 需要手工维护 EndpointSlice,控制器不会自动生成。
kube-proxy

图 3:iptables 模式下 Service 到 Pod 的 DNAT
kube-proxy watch Service 和 EndpointSlice,把规则同步到节点。它不在数据路径上逐包转发,真正转发由内核 netfilter/ipvs 完成。
| 模式 | 数据面 | 状态 | 适用 |
|---|---|---|---|
iptables |
netfilter 规则 + conntrack | 1.37 默认;未来默认会切到 nftables | 通用,规则多时同步/匹配成本上升 |
nftables |
nftables 规则 | 需要内核 5.13+;新集群建议评估 | 大规模 Service、Endpoint 变更频繁 |
ipvs |
内核 IPVS 哈希表 | 1.35 起废弃;1.40 默认禁用;1.43 移除 | 存量集群,不建议新选 |
kernelspace |
Windows 内核 | Windows 节点唯一模式 | Windows |
几个关键差异:
- NodePort 监听:iptables 模式默认在所有本地 IP 上可达;nftables 模式默认
--nodeport-addresses primary,只在主 IP 上可达。 - 防火墙:iptables 模式会为 NodePort 自动插入放行规则;nftables 模式不会,节点防火墙要显式放行。
- conntrack 兼容:旧内核(< 6.1)有长连接被重置的 bug,iptables 模式带 workaround,nftables 模式默认不带;必要时用
--conntrack-tcp-be-liberal。 - IPVS:用哈希表做负载均衡,规则多时性能好,但已进入废弃流程;新集群不要把它作为长期方案。
无论哪种模式,NodePort 都不是 kube-proxy 进程监听端口,而是转发规则;ss -lntp 看不到。kube-proxy 只负责写规则和清理规则。
主要 iptables 链:
KUBE-SERVICES:入口,匹配 ClusterIPKUBE-NODEPORTS:NodePort 入口KUBE-SVC-*:Service 到后端的分发KUBE-SEP-*:具体 EndpointKUBE-MARK-MASQ:源地址伪装KUBE-POSTROUTING:出站 SNAT/masquerade
conntrack 是 Service 能“反向 NAT”的关键:DNAT 只改去程包,回程包靠 conntrack 还原。Endpoint 变化后,已有连接仍可能走旧后端,直到连接关闭或 conntrack 老化;这就是“Service 后端已经换了,但长连接还打到旧 Pod”的原因。
多 Endpoint 时,iptables 模式用 statistic 模块按概率逐级跳转到不同 KUBE-SEP-* 链,nftables 模式默认随机选择后端,IPVS 则走调度算法。规则顺序和概率写法会影响实际分布,但设计目标都是均匀;如果观测到严重倾斜,先看 Endpoint 数量、sessionAffinity、连接复用和客户端 NAT。
“Pod 访问自己的 Service”(hairpin)也是常见坑:包从 Pod 出去,DNAT 回同一个 Pod,回程可能因为源/目的地址相同而被丢弃。不同 CNI 对 hairpin 的处理不同,必要时启用 CNI 的 hairpin 模式或避免这种调用方式。
externalTrafficPolicy

图 4:externalTrafficPolicy 对源 IP 和转发路径的影响
Cluster:可以转发到其他节点的 Pod,源 IP 可能被 SNATLocal:只转发到本节点 Pod,保留客户端源 IP;节点没有 Pod 时流量失败
Local 常配合节点本地负载均衡或 DaemonSet 网关使用。
internalTrafficPolicy 与流量分布
internalTrafficPolicy: Local 只把集群内流量发给本节点的 Endpoint。如果本节点没有该 Service 的 Pod,即使其他节点有,当前节点上的客户端也会看到“零 Endpoint”行为。它适合节点本地缓存、DaemonSet 代理、降低跨节点跳数,但会牺牲可用性和负载均衡。
spec.trafficDistribution 控制“优先去哪里”,不是硬性约束:
| 值 | 行为 |
|---|---|
PreferSameZone |
优先同 zone 的 Endpoint;该 zone 没有则回退集群范围 |
PreferSameNode |
优先同节点;没有则回退同 zone,再回退集群范围 |
PreferClose |
旧别名,已废弃,逐步迁移到 PreferSameZone |
| 未设置 | 均匀分发到所有 Endpoint |
交互规则:
externalTrafficPolicy/internalTrafficPolicy为Local时,优先级高于trafficDistribution。- 为
Cluster或未设置时,trafficDistribution才生效。 - 同 zone 优先意味着你要自己评估容量:如果某个 zone 的 Endpoint 很少但流量很大,可能过载;跨 zone 故障切换也要验证。
还有一个旧机制:service.kubernetes.io/topology-mode: Auto(Topology Aware Routing)。它按 zone 的可分配 CPU 比例分配流量,并带有小规模 Endpoint 的回退逻辑;trafficDistribution: PreferSameZone 更简单、更可预测。两者同时存在时,注解优先,未来注解可能被弃用。新配置优先使用 trafficDistribution。
双栈
集群可以同时分配 IPv4 和 IPv6:
ipFamilyPolicy: PreferDualStack |
需要 CNI、kube-proxy、节点和底层网络都支持。双栈排障时先确认 Service 的 ipFamilyPolicy/ipFamilies、EndpointSlice 的 addressType(IPv4/IPv6/FQDN)和 Pod 的 status.podIPs。
ipFamilyPolicy 的三种取值:
| 值 | 行为 |
|---|---|
SingleStack |
只分配一个地址族(默认取集群配置的第一个) |
PreferDualStack |
双栈集群分配两个;单栈集群回退为单栈 |
RequireDualStack |
必须双栈,不满足则创建失败 |
ipFamilies 的顺序决定主地址族:["IPv6", "IPv4"] 表示 IPv6 为主。Service 的 spec.clusterIPs 是主字段,clusterIP 兼容单地址;Pod 用 status.podIPs。
切换 Service 的栈类型是允许的:SingleStack → PreferDualStack/RequireDualStack 会补齐缺失地址族;反向切换只保留 clusterIPs 第一个地址。切换前要确认客户端、CNI、Ingress/LB、NetworkPolicy 和 DNS 都能处理对应地址族。
双栈常见坑:
- 应用只监听 IPv4,IPv6 地址存在但不可用。
- 客户端
getaddrinfo返回 AAAA 后优先走 IPv6,但路径不通。 - NetworkPolicy 的
ipBlock只写了一个地址族。 - 云 LB/NodePort 只暴露了一个地址族。
- 监控/健康检查只探测 IPv4。
Ingress 与 Gateway API
Ingress
Ingress 使用 networking.k8s.io/v1,通过 ingressClassName 绑定 Ingress Controller:
apiVersion: networking.k8s.io/v1 |
Ingress 只描述 L7 路由,实际转发由 Ingress Controller(NGINX、Traefik、HAProxy、云厂商 LB)完成。
pathType 与路由语义
pathType 必填,三种取值:
| 类型 | 匹配规则 | 注意 |
|---|---|---|
Exact |
大小写敏感的完整路径 | /foo 不匹配 /foo/ |
Prefix |
按 / 分段做前缀匹配 |
/foo/bar 匹配 /foo/bar/baz,不匹配 /foo/barbaz |
ImplementationSpecific |
由控制器决定 | 可等价于 Prefix/Exact,也可支持正则 |
Ingress 的能力边界:
- 只支持 host/path 的 L7 路由,标准 API 没有权重、header 匹配、重试、超时、镜像等能力;这些通常靠控制器注解实现,可移植性差。
- 同一个 host/path 被多个 Ingress 命中时,行为由控制器决定,不要依赖未定义的优先级。
defaultBackend处理未匹配请求;没有默认后端时通常返回 404。- TLS 只描述证书 Secret 和 host,证书轮换、重定向、HSTS 等由控制器负责。
ingressClassName绑定控制器;集群可以设置默认 IngressClass,但显式指定更可靠。
Ingress NGINX 退役
Kubernetes SIG Network 已宣布 Ingress NGINX 退役:best-effort 维护持续到 2026 年 3 月,之后不再发布新版本、不再修 bug、也不再修复安全漏洞。已有部署不会被强制破坏,Helm chart 和镜像仍可获取,但继续使用意味着自己承担安全风险。
新项目应优先评估 Gateway API 和仍在维护的控制器;存量集群要制定迁移计划,至少做到:
- 盘点所有 Ingress、注解、TLS 和自定义配置。
- 选择目标控制器,验证路径重写、超时、限流、认证等注解的等价能力。
- 灰度切换入口流量,保留回滚路径。
- 迁移后持续监控证书、错误率和延迟。
Gateway API
Gateway API 通过 CRD 提供更强的表达能力:
GatewayClass:控制器类型Gateway:监听器、端口、TLSHTTPRoute/GRPCRoute:路由规则ReferenceGrant:跨命名空间引用授权
apiVersion: gateway.networking.k8s.io/v1 |
Gateway API CRD 通常需要单独安装,具体版本以官方文档为准。
角色模型与绑定
Gateway API 的核心是“按角色拆分”:
| 角色 | 资源 | 职责 |
|---|---|---|
| 基础设施提供者 | GatewayClass |
定义控制器类型(Istio、Envoy Gateway、Cilium 等) |
| 集群运维 | Gateway |
监听器、端口、TLS、地址、允许哪些 Route 绑定 |
| 应用开发 | HTTPRoute / GRPCRoute / TLSRoute / TCPRoute |
host/path/header 匹配、后端、权重、过滤器;部分 Route 仍在 Experimental Channel |
绑定关系:
HTTPRoute.parentRefs指向Gateway(入口)或Service(GAMMA 网格)。- 跨命名空间绑定需要
ReferenceGrant,不是默认允许。 allowedRoutes控制 Gateway 接受哪些命名空间的 Route。sectionName可以只绑定某个 listener;hostname 必须与 listener 有交集。- Route 的
status.parents[].conditions会告诉你“是否被接受、为什么被拒绝”,排障先看它。
与 Ingress 相比:
- 原生支持权重、header/query/method 匹配、请求/响应头修改、重定向、重写等(具体能力取决于版本和控制器)。
- 支持多控制器共存和跨命名空间授权。
- 有明确的 conformance 测试,控制器能力可验证。
- GAMMA 把同一套 Route 用于东西向 Mesh;入口和网格可以共享 API 心智,但不要混用
Gateway与 Service parent。
GAMMA(Gateway API for Mesh)是另一个方向:HTTPRoute 的 parentRefs 直接指向 Service,不使用 Gateway/GatewayClass,由服务网格/waypoint 执行路由。它把南北向和东西向的路由心智统一到 Route,但 Mesh 场景仍需单独的控制器和 conformance 验证。
迁移时不要逐字段翻译注解。先把 Ingress 的“意图”拆成 Route + 控制器策略,再验证超时、重试、限流、认证、WAF、日志和证书行为是否等价。
DNS
集群 DNS 由 CoreDNS 提供。Service 域名:
<service>.<namespace>.svc.cluster.local |
Pod 域名(Headless Service):
<pod>.<service>.<namespace>.svc.cluster.local |
常见问题:
ndots:5会让短域名先尝试多个 search 域,产生额外查询- 跨命名空间访问建议用 FQDN 或
dnsConfig - Headless Service 返回多个 A/AAAA 记录,客户端要处理轮询和失败重试
- NetworkPolicy 要放行 UDP/TCP 53
resolv.conf 与 ndots
Pod 的 /etc/resolv.conf 大致是:
search default.svc.cluster.local svc.cluster.local cluster.local |
ndots:5 的含义:如果域名中的点少于 5 个,解析器会先依次拼接 search 域,再尝试原域名。访问 api.example.com(2 个点)时,实际可能先查:
api.example.com.default.svc.cluster.local |
这就是“外部域名解析慢/多一次 NXDOMAIN”的常见原因。优化方式:
- 跨命名空间或外部域名使用 FQDN,并加结尾点:
api.example.com.,避免 search 追加。 - 在 Pod 的
dnsConfig.options中调小ndots(例如 2),但会影响集群内短域名解析。 - 用 NodeLocal DNSCache 降低延迟和上游压力。
dnsPolicy:
| 值 | 行为 |
|---|---|
ClusterFirst |
默认,使用集群 DNS,保留 search 域 |
ClusterFirstWithHostNet |
hostNetwork Pod 也使用集群 DNS |
Default |
继承节点 resolv.conf,不保证能解析 Service |
None |
完全自定义,必须提供 dnsConfig |
dnsConfig 可以追加 nameservers、searches、options;hostAliases 可以写 /etc/hosts,适合少量固定域名,不要拿它当服务发现。
Headless、SRV 与 Pod 域名
Headless Service 的 DNS 行为:
- 普通 Service 的 A/AAAA 记录指向 ClusterIP。
- Headless Service 返回所有就绪 Pod 的 IP;客户端自己选择。
publishNotReadyAddresses: true时未就绪 Pod 也会返回,StatefulSet 引导常用。- 命名端口会生成 SRV 记录:
_http._tcp.web.default.svc.cluster.local。
Pod 要获得 <hostname>.<subdomain>... 形式的域名,需要:
- Pod 设置
hostname和subdomain。 - 存在同名的 Headless Service(
subdomain对应 Service 名)。 - Pod 就绪(除非
publishNotReadyAddresses)。
DNS 高可用与性能
- CoreDNS 至少 2 副本,配置 PDB、反亲和、合理的 requests/limits。
- 大规模集群启用 NodeLocal DNSCache,减少跨节点查询和 conntrack 压力。
- 用 Cluster Proportional Autoscaler 或 HPA 按节点/核心数扩 CoreDNS。
- 监控
coredns_dns_requests_total、coredns_dns_responses_total、NXDOMAIN、SERVFAIL、延迟和上游超时。 - DNS 默认 UDP 53,响应过大或截断时会回退 TCP 53;NetworkPolicy 要同时放行 UDP/TCP。
- 负缓存(NXDOMAIN)会放大“刚创建 Service 解析不到”的窗口,发布后要有重试。

图 5:NodeLocal DNSCache 减少 DNS 跨节点查询
NetworkPolicy
NetworkPolicy 是命名空间级的 L3/L4 访问控制,必须由 CNI 实现。Flannel 本身不执行 NetworkPolicy,需要 Calico/Canal/Antrea/Cilium。
默认拒绝入站:
apiVersion: networking.k8s.io/v1 |
允许同命名空间访问:
apiVersion: networking.k8s.io/v1 |
允许特定命名空间:
ingress: |
注意:
podSelector: {}表示本命名空间所有 PodnamespaceSelector和podSelector写在同一个from元素里表示 AND,分开写表示 OR- NetworkPolicy 不处理 DNS 名称,只处理 IP/端口/标签
- 不是身份认证,不能替代 mTLS
隔离与叠加语义
NetworkPolicy 没有“拒绝规则”,只有“允许规则 + 隔离”:
- Pod 没有被任何策略选中:默认允许所有入站/出站。
- Pod 被某条策略的
podSelector选中,且policyTypes包含Ingress:该 Pod 的入站进入隔离状态,只允许所有选中它的策略里ingress规则的并集。 - 出站同理;一旦
policyTypes包含Egress,只允许egress规则的并集。 - 多条策略是并集,不是优先级覆盖;没有“先匹配先生效”。
- 如果
policyTypes省略,Kubernetes 会根据是否存在ingress/egress推断;显式写更安全。
from / to 的语义:
ingress: |
- 不同
from元素之间是 OR。 - 同一个元素里的
podSelector+namespaceSelector是 AND。 ipBlock用 CIDR/except,不解析域名;经过 NAT 后看到的是 NAT 后的地址。endPort支持端口范围(稳定特性),但 CNI 支持情况要验证。- 命名端口(
port: http)依赖 Pod 的容器端口名,跨 Pod 引用时容易出错。
默认拒绝所有入站和出站:
apiVersion: networking.k8s.io/v1 |
然后按依赖逐条放行。启用 Egress 默认拒绝时,必须放行 DNS,否则所有域名解析失败:
egress: |
执行边界
- NetworkPolicy 是 L3/L4,不理解 HTTP/gRPC;L7 策略需要 Cilium、Istio 等方案。
- 策略由 CNI 执行;Flannel 不执行,Calico/Cilium/Antrea 等支持。换 CNI 可能改变策略语义。
- 策略在 Pod 的网络命名空间/节点数据面执行,不同 CNI 对“策略生效前还是 NAT 后”处理不同;排障要以 CNI 文档为准。
hostNetworkPod、节点进程、跨 CNI 网络的流量可能不受策略约束。- NetworkPolicy 不加密、不认证;敏感服务仍需要 mTLS/AuthorizationPolicy。
- Kubernetes 还在推进集群级的
AdminNetworkPolicy/BaselineAdminNetworkPolicy,但日常仍以命名空间级 NetworkPolicy 为主,使用前确认版本和 CNI 支持。
跨节点网络与 CNI 选型
Underlay 与 Overlay
- Underlay:Pod 直接使用底层网络可路由的 IP,性能好,但要求网络团队配合
- Overlay:用 VXLAN/IPIP 等隧道封装,跨子网方便,但有封装开销和 MTU 问题
Calico 常用 BGP underlay,也可选 IPIP/VXLAN;Flannel 常用 VXLAN 或 host-gw;Cilium 可用 native routing 或 tunnel。
封装与 MTU
Overlay 会增加封装头,Pod MTU 必须相应调小:
| 封装 | 额外开销(IPv4 underlay) | 1500 下常见 Pod MTU |
|---|---|---|
| VXLAN | 约 50 字节(Ethernet 14 + IP 20 + UDP 8 + VXLAN 8) | 1450 |
| IPIP | 约 20 字节 | 1480 |
| WireGuard | 约 60 字节(IPv4)/ 80 字节(IPv6) | 1420 左右 |
| 无封装/native routing | 0 | 1500(或 underlay MTU) |
以 CNI 文档为准,不同实现还会加额外头。MTU 不一致的典型现象是:小请求正常,大请求/大响应超时;SSH 能连,HTTP 大文件卡住;TLS 握手偶尔失败。
原因通常是:
- 外层包设置 DF,超过路径 MTU 后被丢弃。
- 路径上的 ICMP “fragmentation needed” 被防火墙丢弃,PMTUD 失效。
- 容器/节点 MTU 配置不一致,TCP MSS 没有正确 clamp。
排查:
# Pod 内查看 MTU |
修复方向:统一 CNI MTU、允许必要的 ICMP、在 CNI/节点配置 TCP MSS clamp,避免应用层自己猜。Jumbo Frame(9000)场景要把封装开销算进去,并确保整条路径一致。
选型考虑
- 是否需要 NetworkPolicy
- 是否需要 eBPF、可观测性、kube-proxy replacement
- 是否有多集群、双栈、Windows 节点
- 网络团队是否支持 BGP/underlay
- 是否需要加密(WireGuard/IPsec)
- 运维复杂度和故障排查成本
CNI 链式与数据面
CNI 插件可以链式执行:主插件负责连通性和 IPAM,附加插件负责端口映射、带宽、调优、策略等。链式顺序会影响行为,升级/替换插件时要检查 /etc/cni/net.d/*.conflist。
两种典型数据面:
- 传统 CNI + kube-proxy:CNI 管 Pod 网络,kube-proxy 管 Service VIP;规则在 iptables/nftables/IPVS。
- eBPF / kube-proxy replacement:Cilium 等用 eBPF 在 socket/TC 层完成 Service 负载均衡和部分策略,减少 iptables/conntrack 路径;L7 仍可能依赖 Envoy 等代理。
eBPF 不是“免费加速”:
- 依赖内核版本和发行版,升级节点 OS 可能影响特性。
- 排障工具和心智与传统 iptables 不同(
bpftool、Hubble、eBPF map)。 - 与云厂商 CNI、NetworkPolicy、服务网格的兼容性要逐项验证。
- kube-proxy replacement 关闭后回退路径要演练。
排障
分层排查模型
不要一上来就抓包。按层缩小范围:
| 层 | 问题 | 先看 |
|---|---|---|
| Pod 网络 | Pod 有没有 IP、能不能到同节点/跨节点 Pod | ip addr、ip route、CNI 日志 |
| Service | VIP 有没有规则、Endpoint 是否就绪 | EndpointSlice、iptables-save/nft list、conntrack |
| DNS | 域名解析到哪、是否走错 search 域 | resolv.conf、dig、CoreDNS 日志 |
| 入口 | Ingress/Gateway 是否接受路由、证书是否有效 | Route status、控制器日志、证书 |
| 外部 | 云 LB/安全组/防火墙/NAT | LB 后端、安全组、tcpdump |
| 策略 | NetworkPolicy/CNI 是否拒绝 | kubectl describe netpol、CNI 策略计数器 |
一个实用判断:
能解析,但连不上 → Service/Endpoint/NetworkPolicy/端口 |
常用命令
kubectl get pods -A -o wide |
节点侧:
crictl ps |
conntrack -S 里的 insert_failed/drop 增长,通常意味着 conntrack 表满或规则冲突;dmesg | grep conntrack 可以看到 nf_conntrack: table full。
典型故障
Pod 之间不通
- Pod 是否在同一 CNI 网络
- NetworkPolicy 是否拦截
- 节点路由/BGP/隧道是否正常
- MTU 是否一致
Pod 访问 Service 不通
- EndpointSlice 是否有后端
- Service selector 和 targetPort 是否正确
- kube-proxy 是否正常
- conntrack 是否有旧连接
- NetworkPolicy 是否放行
外部访问 NodePort/LoadBalancer 不通
- externalTrafficPolicy 是否 Local 且节点无 Pod
- 云安全组/防火墙
- LoadBalancer 是否有 external IP
- kube-proxy 规则是否存在
DNS 解析失败
- CoreDNS 是否 Running
- NetworkPolicy 是否放行 53
ndots和 search 域- NodeLocal DNSCache 是否正常
症状速查
| 症状 | 优先怀疑 | 验证 |
|---|---|---|
ping Service VIP 不通 |
VIP 是虚拟地址,不一定响应 ICMP | 用 curl/nc 测端口,不要用 ping 判断 Service |
| 能连 Pod IP,不能连 Service VIP | Endpoint/kube-proxy/conntrack | endpointslices、iptables-save、conntrack -L |
Connection refused |
目标端口没有监听、targetPort 错 | Pod 内 ss -lntup、Service targetPort |
Connection timed out |
NetworkPolicy、路由、MTU、防火墙 | tcpdump 看 SYN 是否有回包 |
| 同节点通、跨节点不通 | overlay/BGP/路由/防火墙 | 节点路由、隧道、tcpdump 两端 |
| 小包通、大包超时 | MTU/PMTUD | ping -M do -s 1472 |
| 偶发超时,重试恢复 | conntrack、Endpoint 终止、负载倾斜 | conntrack -S、EndpointSlice 条件、后端分布 |
| NodePort 在部分节点不通 | externalTrafficPolicy: Local、节点防火墙 |
节点是否有 Pod、KUBE-NODEPORTS、安全组 |
| 客户端源 IP 丢失 | SNAT、externalTrafficPolicy: Cluster |
对比 Local、看 conntrack/NAT |
| DNS 间歇性 SERVFAIL | CoreDNS 过载、上游超时、UDP 丢包 | CoreDNS 指标、dig +tcp、NodeLocal |
| 发布后少量请求打旧 Pod | conntrack 旧连接、Terminating Endpoint | conntrack -L、EndpointSlice terminating |
| 改 Service 后仍走旧后端 | kube-proxy 未同步、长连接 | proxy 规则版本、重启客户端连接 |
企业实践
网段规划
- Pod CIDR、Service CIDR 不与 IDC、VPC、VPN、其他集群重叠
- 每个集群预留足够地址,考虑节点数、Pod 密度和未来扩容
- 多集群统一规划,避免跨集群访问时路由冲突
- 双栈集群同时规划 IPv4/IPv6,并确认 CNI、kube-proxy、节点和底层网络都支持
- 网段记录到 IPAM/CMDB,变更走审批,不要临时改 Service CIDR
Service CIDR 是 apiserver 启动参数的一部分,变更通常意味着重建集群。规划时至少预留:
- 每个节点 Pod 子网能容纳峰值 Pod 数(含滚动更新、Job、临时 Pod)。
- 未来 2–3 年节点数和集群扩容。
- 双栈的两个地址族。
- 与 VPC、IDC、VPN、专线、其他集群、灾备集群不重叠。
kube-proxy 模式与升级
Kubernetes 1.37 的默认仍是 iptables,但官方明确未来会把默认切到 nftables。为了避免升级时“模式悄悄变了”,生产集群应显式配置 kube-proxy 模式:
apiVersion: kubeproxy.config.k8s.io/v1alpha1 |
模式选择:
iptables:兼容性最好,规则多时同步慢。nftables:内核 5.13+,Endpoint 变更更快,适合大规模;但 NodePort 默认只监听主 IP,节点防火墙要显式放行。ipvs:1.35 起废弃,1.40 默认禁用,1.43 移除;存量可以继续跑,但要有迁移计划。
升级/切换前:
- 在 canary 节点验证 Service、NodePort、LoadBalancer、NetworkPolicy、conntrack。
- 确认节点内核、nftables 版本、防火墙规则。
- 监控
kube-proxy同步延迟、规则数量、conntrack 使用率。 - 保留回滚到旧模式的路径。
CNI 选型
选型不只看“能不能通”,还要看长期运维:
- 是否需要 NetworkPolicy,是否需要 L7 策略
- 是否需要 eBPF、kube-proxy replacement、Hubble 等可观测性
- 是否有多集群、双栈、Windows 节点
- 网络团队是否支持 BGP/underlay
- 是否需要 WireGuard/IPsec 加密
- 社区活跃度、商业支持、升级路径和故障排查资料
- 更换 CNI 通常需要重建集群或复杂迁移,不要频繁更换
常见组合:
- 简单场景:Flannel + 独立 NetworkPolicy 方案(Canal)
- 通用生产:Calico(BGP/overlay + NetworkPolicy)
- eBPF/高性能/可观测性:Cilium
- 云厂商:托管 CNI,结合云网络和安全组
NetworkPolicy 设计
- 默认拒绝入站,按需拒绝出站
- 按应用依赖放行,不要按 Namespace 全开
- DNS、监控、apiserver、Ingress/Gateway 单独放行
- 策略纳入 GitOps,先在测试集群验证
- 注意不同 CNI 对 policy 的支持差异(例如 Flannel 不执行 policy)
- 定期审计“全开”策略和长期未使用的放行规则
- NetworkPolicy 不是身份认证,敏感服务仍需要 mTLS 和授权
Service 与入口
- 内部服务优先 ClusterIP + DNS,不要滥用 NodePort
- 需要保留客户端源 IP 时用
externalTrafficPolicy: Local,同时接受节点本地无 Pod 时流量失败的风险 - 裸金属 LoadBalancer 用 MetalLB 或 BGP 实现,不要假设云厂商自动创建
- 入口统一到 Ingress/Gateway,不要每个团队自己暴露 NodePort
- 统一规划 TLS 终止位置、证书管理和重定向策略
- 入口层做限流、WAF、访问日志、trace 和灰度
- Ingress-NGINX 退役后,新项目优先 Gateway API
入口迁移检查
Ingress NGINX 的 best-effort 维护到 2026 年 3 月,之后不再有版本、bugfix 和安全修复。存量迁移不要只做 YAML 转换:
- 盘点:
kubectl get ingress -A -o yaml,记录 controller、annotations、TLS、host/path、重写、超时、限流、认证、WAF。 - 能力映射:目标控制器是否支持 path 重写、正则、灰度、header 操作、外部认证、mTLS、限流、日志格式。
- 双跑:新旧入口同时存在,用 DNS 权重/LB 权重灰度;不要一次性切换。
- 证书:确认 Secret 类型、SAN、证书链、自动轮换和 TLS 版本。
- 可观测性:错误率、延迟、4xx/5xx、上游超时、证书到期都要有看板。
- 回滚:保留旧 Ingress/Service 和 DNS 记录,明确回滚触发条件。
Gateway API 的 status.parents[].conditions 是迁移期最好的检查点:Route 没被接受时,先看 condition,而不是猜控制器行为。
DNS
- CoreDNS 多副本、PDB、反亲和
- 大规模集群用 NodeLocal DNSCache 降低延迟和跨节点查询
- 控制
ndots和 search 域,避免大量无效查询 - NetworkPolicy 放行 UDP/TCP 53
- 监控 DNS 延迟、NXDOMAIN、CoreDNS 错误和上游超时
- 跨命名空间访问使用 FQDN,减少 search 域依赖
MTU 与性能
- overlay 场景统一 MTU,VXLAN 常见 1450,具体按封装头计算
- 验证大包、跨节点、跨可用区,避免“小请求正常、大请求超时”
- eBPF 模式关注内核版本、特性开关和 CNI 版本
- 高吞吐场景评估 underlay/native routing
- 用 iperf/netperf 做基准测试,记录基线
多集群
- Pod/Service CIDR 不重叠
- 跨集群 DNS、网关、证书和策略统一规划
- 东西向网关和 NetworkPolicy 要单独设计
- 不要只靠多集群做多租户隔离,成本和运维复杂度会上升
- 明确故障域和流量切换方案
排障体系
- 分层排查:Pod 网络 → Service → Ingress/Gateway → 外部网络
- 标准化命令:
get endpointslices、getent hosts、tcpdump、conntrack - 保留网络拓扑、CIDR、路由和流量路径文档
- 重大变更前做连通性、MTU 和 DNS 验证
- 把常见故障和排查步骤写成 runbook
网络变更检查清单
上线/变更前:
- Pod/Service CIDR 与 VPC、IDC、VPN、其他集群不重叠。
- CNI 版本、内核版本、kube-proxy 模式已记录并固定。
- 节点 Pod 子网容量足够,IPAM 回收正常。
- overlay MTU 一致,跨节点大包测试通过。
- NetworkPolicy 默认拒绝,DNS/监控/入口/依赖已放行。
- CoreDNS 多副本、PDB、NodeLocal/自动扩缩容已评估。
- Ingress/Gateway 的 host、TLS、pathType、超时和重试已验证。
- 变更窗口、灰度比例、回滚路径和观察指标明确。
变更后:
-
kubectl get pods -o wide、endpointslices正常。 - 同节点/跨节点 Pod 互通。
- ClusterIP、NodePort、LoadBalancer 三类入口都验证。
- DNS 正向/反向/跨命名空间解析正常。
-
conntrack -S无异常增长,dmesg无 table full。 - 延迟、错误率、重试率没有回归。
- 旧规则/旧 Endpoint/旧入口按计划清理。