


本文基于 Kubernetes v1.37 官方文档重写,覆盖节点管理、kubeadm 集群生命周期、升级、证书、etcd 备份、自动扩缩容、资源治理和可观测性。
- 节点管理
- 集群安装与高可用
- 版本升级
- 证书管理
- etcd 备份与恢复
- 自动扩缩容
- 资源治理
- 可观测性
- 灾备与演练
- 排障
- 企业实践
- 控制面与 HA 拓扑
- kubeadm 生命周期
- 升级深水区
- 证书深水区
- etcd 运维深水区
- 调度与容量
- 自动扩缩容深水区
- 网络与 IPAM
- 存储运维
- 可观测性深水区
- 灾备与多集群
- 联邦集群与多集群
- 故障案例与排查
- 生产检查清单
- 官方参考
节点管理
Node 状态
kubectl get nodes -o wide |
常见 Conditions:
Ready:kubelet 健康、网络可用MemoryPressure:内存压力DiskPressure:磁盘压力PIDPressure:进程数压力NetworkUnavailable:网络未就绪
节点 NotReady 时,Pod 不会立即被驱逐:默认约 40s 标记 NotReady,随后 NoExecute 污点的 tolerationSeconds=300 到期才开始驱逐;分别由 node-monitor-grace-period 和污点容忍控制。
隔离与恢复
kubectl cordon <node> # 标记不可调度 |
drain 会:
- 驱逐节点上的 Pod
- 遵守 PDB
- 跳过 DaemonSet(需要
--ignore-daemonsets) - 删除 emptyDir 数据(需要
--delete-emptydir-data)
节点维护前要确认关键服务有多副本和 PDB。
污点与容忍
kubectl taint node <node> dedicated=gpu:NoSchedule |
Pod 需要对应 toleration:
tolerations: |
控制平面污点通常是 node-role.kubernetes.io/control-plane:NoSchedule;旧 master 污点在新集群中不再默认存在。
节点扩容
- 云环境:Cluster Autoscaler、Karpenter、节点池
- 裸金属:手动加入节点或使用 Cluster API
- 新节点加入后确认 CNI、kube-proxy、kubelet、容器运行时和证书正常

图 1:节点 Capacity、Allocatable 与资源保留
节点可分配资源 = Capacity - 系统保留 - kubelet 保留 - 驱逐阈值。调度只看 requests。
集群安装与高可用
kubeadm 高可用
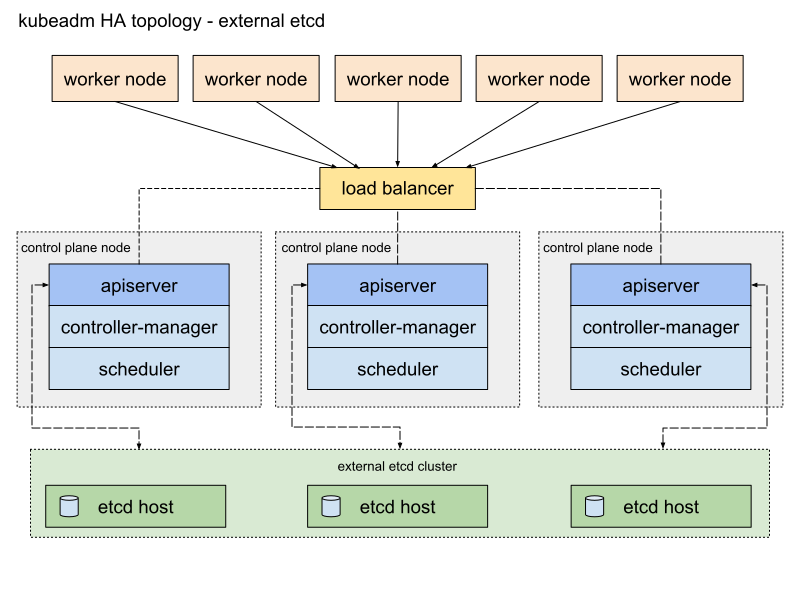
图 2:kubeadm 高可用集群(外部 etcd)
生产建议:
- 控制面至少 3 个节点
- etcd 3 或 5 副本,独立磁盘
- apiserver 前放负载均衡器
- kubelet/kubectl 通过 VIP 访问
- 控制面和 etcd 做反亲和
初始化
kubeadm init --control-plane-endpoint=<VIP>:6443 \ |
加入 worker:
kubeadm join <VIP>:6443 --token <token> \ |
加入其他控制面:
kubeadm join <VIP>:6443 --token <token> \ |
安装 CNI 后再确认 CoreDNS 和节点 Ready。
kubeadm 配置
kubeadm 配置 API 会随版本演进,使用当前版本生成模板:
kubeadm config print init-defaults |
当前 kubeadm 配置 API 是 kubeadm.k8s.io/v1beta4。使用当前版本生成模板,不要照抄旧版本的 v1beta2/v1beta3 配置。
版本升级
原则:
- 一次只升一个 minor
- 先控制面,再 kubelet/kube-proxy,最后工作负载
- 升级前扫描已移除 API
- 升级前备份 etcd
- 升级后验证 CNI、CoreDNS、Ingress、存储和关键业务
版本偏差:
- kubelet、kube-proxy 最多可落后 apiserver 3 个 minor
- kube-controller-manager、kube-scheduler、cloud-controller-manager 最多落后 apiserver 1 个 minor,且不得新于 apiserver
- kubectl 支持 ±1 个 minor
- HA 中 apiserver 实例之间最多差 1 个 minor
具体以官方 Version Skew Policy 为准。
升级前检查 cgroup 版本:v1.37 的 kubelet 默认 FailCgroupV1: true,只支持 cgroup v2。cgroup v1 节点必须先迁移到 v2,否则升级后 kubelet 启动失败。
控制面升级
kubeadm upgrade plan |
第一个控制面节点用 apply;其余控制面节点先升级 kubeadm 包,再执行 kubeadm upgrade node。
节点升级
kubectl drain <node> --ignore-daemonsets --delete-emptydir-data |
逐个节点升级,确认业务可用后再继续。
升级前检查
kubectl api-resources |
可用 pluto、kubent 等工具扫描已移除 API。
证书管理
kubeadm certs check-expiration |
要点:
- CA 有效期长,叶子证书通常 1 年
- 升级时注意轮换
- kubelet 客户端证书可以开启自动轮换
- 不要把私钥提交到 Git
- 所有控制面共享同一 CA;在每个控制面节点分别执行
kubeadm certs renew all并重启静态 Pod,不要复制叶子证书
etcd 备份与恢复
备份
etcdctl snapshot save snapshot.db \ |
恢复
etcdutl --data-dir=/var/lib/etcd-restore snapshot restore snapshot.db |
恢复前要停止所有 apiserver 和 etcd 进程;在所有 etcd 成员上恢复同一快照并配置 initial-cluster,再重启 etcd 和 apiserver。etcdctl snapshot restore 已标记为 Deprecated,优先使用 etcdutl。
注意:
- 不要直接复制 etcd 数据目录
- 定期做恢复演练
- 关注 quorum、defrag、compaction
- 备份文件要异地保存并加密
自动扩缩容
HPA

图 3:HPA 根据指标调整副本数
apiVersion: autoscaling/v2 |
依赖 metrics-server 或自定义指标适配器;没有 requests 时 CPU 利用率无法计算。
VPA

图 4:VPA 架构
VPA 默认 controlledValues: RequestsAndLimits,同时调整 requests 和 limits;只调整 requests 时显式设置 RequestsOnly。updateMode 支持 Off、Initial、Recreate、InPlaceOrRecreate、InPlace(以版本支持为准)。需要单独部署 CRD 和组件。与 HPA 同时使用时注意指标冲突,常见做法是 HPA 用 CPU/自定义指标,VPA 只做推荐模式。
Cluster Autoscaler
按 Pending Pod 扩容节点,缩容时尊重 PDB、DaemonSet 和本地存储。云上也可用 Karpenter 做更灵活的节点供给。
资源治理
Requests/Limits
- 所有 Pod 设置 requests/limits
- CPU limit 过紧会导致节流
- 内存 limit 过紧会 OOMKilled
- requests 决定调度和容量规划
LimitRange
apiVersion: v1 |
ResourceQuota
apiVersion: v1 |
PV 是集群级资源,不在 Namespace 配额内;配额统计的是 PVC 数量和存储请求。
可观测性
- metrics-server:Resource Metrics API
- Prometheus + Grafana:集群、节点、Pod、控制器指标
- 日志:Fluent Bit/Vector → Loki/Elasticsearch
- 事件:
kubectl get events --sort-by=.lastTimestamp - 审计日志:apiserver audit policy
- 控制面指标:apiserver、etcd、scheduler、controller-manager
关键告警:
- 节点 NotReady
- etcd leader 变化、fsync 延迟、quorum 风险
- apiserver 5xx、限流
- Pending Pod 持续增长
- PVC 使用率、inode
- HPA 达到 maxReplicas
- 证书到期
灾备与演练
- 定期备份 etcd、PVC 快照、GitOps 仓库和密钥
- 定期做节点故障、控制面故障、可用区故障演练
- 验证恢复时间目标(RTO)和恢复点目标(RPO)
- 多集群场景设计好 DNS、证书、网络和流量切换
- 不要只备份不演练
排障
节点 NotReady
systemctl status kubelet |
检查:
- kubelet 证书
- 容器运行时
- CNI
- 磁盘/inode
- 内存/PID 压力
- apiserver 连通性
Pending
- 资源不足
- 污点/亲和性
- PVC 未绑定
- 节点 NotReady
- 配额不足会在创建阶段直接拒绝(Forbidden),不是 Pending;PDB 只影响驱逐,不影响调度
kubectl describe pod <pod> -n <ns> |
频繁驱逐
- 节点 MemoryPressure/DiskPressure/PIDPressure 和 kubelet 驱逐阈值
- requests 过大导致 Pending;超过 CPU limit 导致节流,超过 memory limit 导致 OOMKilled
- 检查 QoS 和 PriorityClass
升级失败
- 版本跨度过大
- 已移除 API
- 证书过期
- CNI/CRI 不兼容
- etcd 不健康
- Kubernetes 不支持 minor 就地降级;失败时重跑
kubeadm upgrade(幂等)或kubeadm upgrade apply --force,必要时从 etcd 快照恢复并用相同版本重建控制面
企业实践
集群拓扑
- 控制面至少 3 节点,etcd 3 或 5 副本,跨可用区部署
- 控制面、etcd、工作负载按故障域反亲和
- 不要盲目增加小集群;优先“少量大集群 + Namespace 多租户”
- 需要强隔离、合规或不同网络域时再拆集群
- 区分管理集群和业务集群,避免平台组件和业务互相影响
- 负载均衡器放在 apiserver 前,kubelet/kubectl 通过 VIP 访问
节点池
按业务拆分节点池:
- 系统池:CoreDNS、CNI、Ingress、监控、日志
- 普通业务池:无状态服务
- GPU/高性能池:AI、渲染、视频
- 内存型池:缓存、大数据
- Spot/抢占池:可中断的批处理和无状态服务
配套:
- 用 taint/toleration 和 nodeAffinity 隔离
- 节点镜像标准化,预装运行时、CNI、监控 agent
- 节点自动修复和替换,避免手工修节点
- 控制节点最大 Pod 数、IP 耗尽和磁盘水位
- 节点维护走 cordon/drain/uncordon,遵守 PDB
升级
- 一次只升一个 minor,先测试集群再生产
- 控制面 → kubelet/kube-proxy → 工作负载
- 第一个控制面用
kubeadm upgrade apply,其余用kubeadm upgrade node - 升级前扫描已移除 API,备份 etcd,确认 cgroup v2
- 升级后验证 CNI、CoreDNS、Ingress、存储和关键业务
- Kubernetes 不支持 minor 降级,回滚以应用层和配置层为主
- 设置变更窗口和冻结期,避免和大促/发布冲突
证书与 etcd
- 所有控制面共享同一 CA,每个节点分别 renew,不复制叶子证书
kubeadm certs check-expiration纳入监控- kubelet 客户端证书开启自动轮换
- etcd 使用
etcdutl snapshot save备份,异地加密保存 - 恢复前停止 apiserver/etcd,在所有成员上恢复同一快照
- 定期做恢复演练,验证 RTO/RPO
- 关注 etcd quorum、fsync 延迟、defrag 和 compaction
自动扩缩容
- HPA:按 CPU/内存/自定义指标扩 Pod,设置 maxReplicas 和 behavior
- VPA:默认只调 requests,适合 rightsizing;和 HPA 同时用要避免冲突
- Cluster Autoscaler/Karpenter:按 Pending Pod 扩节点
- 设置节点上限和预算告警,防止成本失控
- 考虑冷启动、镜像拉取、CNI IP 和调度拓扑
- 缩容尊重 PDB、DaemonSet、本地存储和长连接
可观测性
- 指标:集群、节点、Pod、控制器、etcd、apiserver、scheduler
- 日志:系统组件、审计、业务日志统一采集
- 事件:
kubectl get events纳入告警 - 审计:apiserver audit 接入 SIEM
- SLO:可用性、延迟、错误率、饱和度
- 告警分级:P0/P1 电话,P2 工单,避免告警疲劳
灾备
- 明确 RTO/RPO,按业务分级
- 备份 etcd、PVC 快照、GitOps 仓库、密钥和镜像
- 多集群/多区域设计 DNS、证书、网络和流量切换
- 恢复顺序:基础设施 → 控制面 → 网络/存储 → 工作负载
- 定期演练节点故障、控制面故障、可用区故障和误删恢复
- 不要只备份不演练
变更管理
- 集群组件和应用配置都走 GitOps
- 变更前 diff、dry-run、测试集群验证
- 高风险变更双人复核,保留回滚方案
- 记录变更窗口、影响范围和验证步骤
- 变更后观察 SLO 和关键业务指标
- 定期清理技术债和手工配置漂移
控制面与 HA 拓扑
Stacked vs External etcd
| 拓扑 | 说明 | 适用 |
|---|---|---|
| Stacked etcd | etcd 与控制面同节点,kubeadm 默认 | 中小集群、简化运维 |
| External etcd | etcd 独立集群 | 大规模、强隔离、独立运维 |
Stacked 的风险:
- 控制面节点故障同时影响 apiserver 和 etcd。
- etcd 与控制面争 CPU/磁盘。
- 升级/维护窗口耦合。
External etcd 的要求:
- 独立 3/5 节点,奇数 quorum。
- 专用低延迟 SSD,独立网络。
- apiserver 配置多个 etcd endpoints。
- TLS 证书、CA、客户端证书统一管理。
控制面 HA
- 至少 3 个控制面节点,跨可用区/机架。
- apiserver 前放 L4/L7 负载均衡,健康检查
/readyz。 - kubelet/kubectl 使用
controlPlaneEndpoint/VIP,不直连单节点。 - 控制面节点反亲和,避免同宿主/同机架。
- controller-manager/scheduler 通过 leader election 只活跃一个。
- apiserver 实例之间版本偏差不超过 1 个 minor。
- 证书 SAN 必须包含 VIP、所有控制面 IP/DNS、负载均衡地址。
apiVersion: kubeadm.k8s.io/v1beta4 |
etcd quorum
- 3 节点容忍 1 个故障;5 节点容忍 2 个。
- 偶数节点不提升容错,反而增加复制成本。
- quorum 丢失时 apiserver 无法写,集群进入只读/不可用。
- 监控
etcd_server_has_leader、leader 切换、WAL fsync、backend commit、DB 大小。 - etcd 故障恢复优先恢复 quorum,不要盲目重建单节点。
kubeadm 生命周期
配置 API
kubeadm config print init-defaults |
当前配置 API 为 kubeadm.k8s.io/v1beta4。不要照抄旧版本的 v1beta2/v1beta3 示例。
常见配置块:
InitConfiguration:bootstrap token、API endpoint、node registration。ClusterConfiguration:controlPlaneEndpoint、networking、etcd、apiServer、controllerManager、scheduler。KubeletConfiguration:cgroup driver、eviction、maxPods、runtime。JoinConfiguration:discovery、controlPlane、nodeRegistration。
建议用 patches 而不是复制整份默认配置:
apiVersion: kubeadm.k8s.io/v1beta4 |
kubeadm init --config kubeadm-config.yaml --patches ./patches |
初始化流程
kubeadm init \ |
--upload-certs 把控制面证书加密上传到集群 Secret,供其他控制面加入;证书 key 默认 2 小时有效。
加入节点
# worker |
生成 join 命令:
kubeadm token create --print-join-command |
要点:
- bootstrap token 默认 24h 过期,用后清理。
--discovery-token-ca-cert-hash防止中间人。- 控制面加入需要 certificate key;证书 key 过期需重新上传。
- 加入前确认 CRI、kubelet、CNI、时间同步、swap 关闭。
- 加入后用
kubectl get nodes、kubectl get --raw /readyz验证。
Kubelet TLS Bootstrap
- kubelet 用 bootstrap token 申请客户端证书。
- CSR 由 controller-manager 自动批准/签名(或外部 signer)。
- 客户端证书默认轮换,避免一年过期。
- 服务端证书轮换需要
--rotate-server-certificates和 CSR 批准。 - 检查:
kubectl get csr |
kubeadm phases
kubeadm 的每个阶段可单独执行,便于排障/自动化:
kubeadm init phase preflight |
kubeadm reset 会清理节点上的 Kubernetes 配置,但不会自动清理 CNI、etcd 数据、PVC;执行前确认。
升级深水区
Version Skew
以 v1.37 为例:
- kubelet 不能比 apiserver 新,最多落后 3 个 minor。
- kube-proxy 不能比 apiserver 新,最多落后 3 个 minor。
- kubectl 支持 ±1 minor。
- controller-manager/scheduler/cloud-controller-manager 最多落后 1 个 minor,且不能比 apiserver 新。
- HA 中 apiserver 实例之间最多差 1 个 minor。
升级前检查:
kubectl version |
升级原则
- 一次只升一个 minor。
- 先控制面,再 kubelet/kube-proxy,最后工作负载。
- 升级前备份 etcd/关键数据。
- 扫描已移除/弃用 API。
- 确认 cgroup v2:v1.37 kubelet 默认
FailCgroupV1: true。 - 升级前 drain 节点,遵守 PDB。
- 升级后验证 CNI、CoreDNS、Ingress、存储、关键业务。
- 不支持 minor 就地降级;回滚靠 etcd 快照/重建或应用层回滚。
控制面升级
# 第一个控制面 |
kubeadm upgrade apply会检查集群可升级、版本偏差、拉取镜像、升级控制面、CoreDNS/kube-proxy,并在证书 180 天内到期时轮换。kubeadm upgrade node用于其他控制面/worker,获取 ClusterConfiguration 并升级静态 Pod 配置/kubelet 配置。- 升级失败可重跑(幂等);必要时
kubeadm upgrade apply --force。 - kubeadm 会在
/etc/kubernetes/tmp写 etcd/manifests 备份。
Worker 升级
kubectl drain <node> --ignore-daemonsets --delete-emptydir-data |
- 一次升级一个或少量节点,保证容量。
- PDB 会阻止 drain 过度中断;必要时调整 PDB,但要评估风险。
- 本地存储/emptyDir 数据会被删除,需
--delete-emptydir-data并确认可丢。 - DaemonSet 需要
--ignore-daemonsets。 - 升级后检查 kubelet、CNI、Pod、Service、DNS。
API 移除与弃用
kubectl api-resources |
工具:
pluto:扫描已移除 API。kubent:检查废弃 API。kubectl convert(需要插件)迁移 manifest。- 关注 release notes 的 deprecation/removal。
升级失败恢复
- 重跑
kubeadm upgrade,它是幂等的。 - 检查
/etc/kubernetes/tmp备份。 - 检查静态 Pod、kubelet、CNI、证书、etcd quorum。
- 必要时从 etcd 快照恢复并重建控制面。
- 不要强行把高版本 kubelet 降到低版本 apiserver 之外的范围。
证书深水区
证书体系
kubeadm 集群常见证书:
ca.crt/key:集群 CA。apiserver.crt/key:apiserver 服务端。apiserver-kubelet-client.crt:apiserver → kubelet 客户端。front-proxy-ca.crt、front-proxy-client.crt:聚合 API。etcd/ca.crt、etcd/server.crt、etcd/peer.crt、etcd/healthcheck-client.crt、apiserver-etcd-client.crt。admin.conf、controller-manager.conf、scheduler.conf。sa.key、sa.pub:ServiceAccount token 签名。
有效期:
- CA 通常 10 年。
- 叶子证书通常 1 年。
- kubelet 客户端证书自动轮换。
- apiserver 服务端证书在
kubeadm upgrade时可能轮换。
检查与续期
kubeadm certs check-expiration |
续期后:
- 重启控制面静态 Pod(apiserver/controller-manager/scheduler/etcd)。
- 每个控制面节点分别执行,不要复制叶子证书。
- 检查 kubeconfig 中的证书是否更新。
- 外部 CA 需要 CSR 流程,kubeadm 不能管理外部 CA 签发的证书。
SAN 与访问地址
证书 SAN 必须包含:
controlPlaneEndpoint/VIP。- 所有控制面节点 IP/DNS。
kubernetes、kubernetes.default、kubernetes.default.svc、kubernetes.default.svc.cluster.local。- 负载均衡地址/外部域名。
新增控制面/更换 VIP 后要更新 SAN 并重新签发,否则 kubelet/kubectl 会报证书不匹配。
Kubelet 证书轮换
- 客户端证书:
--rotate-certificates,由 kubelet 自动申请/轮换。 - 服务端证书:
--rotate-server-certificates,需要 CSR 批准。 - 检查
/var/lib/kubelet/pki/。 - 证书过期会导致节点 NotReady、kubectl logs/exec 失败。
- 监控证书到期时间,不要等过期。
etcd 运维深水区
拓扑与 quorum
- Stacked etcd:控制面节点本地 static pod。
- External etcd:独立集群,apiserver 配置多个 endpoints。
- 3/5 节点,奇数 quorum。
- 跨可用区部署,避免同故障域。
- 专用 SSD,低 fsync 延迟;不要和重 IO 业务混部。
- 监控 leader、WAL fsync、backend commit、DB 大小、quota、alarm。
备份
etcdctl snapshot save /backup/etcd-$(date +%F-%H%M).db \ |
- 定期备份,异地加密保存。
- 同时备份证书、kubeadm 配置、GitOps 仓库、PVC 快照。
- 备份后验证
etcdutl snapshot status。 - 不要只复制运行中的 data-dir。
恢复
etcdutl --data-dir=/var/lib/etcd-restore snapshot restore snapshot.db |
流程:
- 停止所有 apiserver 和 etcd。
- 在所有 etcd 成员上恢复同一快照,配置一致的 initial-cluster。
- 启动 etcd,确认 quorum/leader。
- 启动 apiserver/controller-manager/scheduler/kubelet。
- 验证 API、节点、工作负载。
- 恢复后检查 revision/证书/网络。
注意:
- 不要只恢复一个成员就启动整个集群。
- 恢复的是 etcd 数据,不包含 PV 数据。
- 恢复后可能需要重启控制面组件,避免旧 leader lock。
- 恢复演练必须定期做。
成员替换
member list找到故障成员 ID。- 从 apiserver
--etcd-servers移除故障成员(如需要)。 member remove <id>。- 新节点用相同 name/peer URL 加入。
- 等待同步,检查 health/hashkv。
- 一次只替换一个成员。
维护
- Compaction:清理历史 revision,避免 DB 无限增长。
- Defrag:回收磁盘空间;会阻塞成员读写,逐个执行。
- Quota/NOSPACE:删除数据 → compaction → defrag → alarm disarm。
- Alarm:
alarm list、alarm disarm。 - HashKV:比较成员数据一致性。
- etcd-defrag 可作为 CronJob 定期执行。
- 磁盘延迟是 etcd 的头号敌人;WAL fsync p99 要重点监控。
调度与容量
调度基础
kube-scheduler 只看 requests,不看实际使用量:
- 节点 Allocatable = Capacity - 系统保留 - kubelet 保留 - 驱逐阈值。
- requests 决定 Pod 能否调度。
- limits 决定运行时上限(CPU 节流、内存 OOM)。
- QoS:Guaranteed、Burstable、BestEffort。
- 优先级/抢占:PriorityClass、system-cluster-critical、system-node-critical。
- 拓扑:nodeAffinity、podAffinity、topologySpreadConstraints、taints/tolerations。
PDB
apiVersion: policy/v1 |
- PDB 只影响自愿中断(drain、eviction),不影响节点故障/调度。
minAvailable/maxUnavailable二选一。- drain 会遵守 PDB;PDB 太严会导致维护卡住。
- 单副本服务设置 PDB 可能永远无法 drain,需要先扩容或调整。
- 健康 Pod 的判定、
unhealthyPodEvictionPolicy按版本支持。
节点压力驱逐
kubelet 根据阈值驱逐:
memory.availablenodefs.availableimagefs.availablepid.available
驱逐顺序按 QoS/优先级:
- BestEffort
- Burstable 超出 requests
- Guaranteed/关键 Pod 最后
配置:
evictionHard: |
注意:
- 驱逐不是“杀 Pod”这么简单,要保证副本/PDB/容量。
- 磁盘/inode 压力可能导致镜像/日志被清理。
- 监控
kubelet_evictions、节点压力条件、Pod 重启。
容量规划
- 按峰值 + 故障切换容量规划。
- 留出 headroom(CPU/内存/磁盘/IP)。
- 关注 Pod 密度、IP 耗尽、maxPods、CNI 限制。
- 节点池按业务/硬件/Spot 拆分。
- 用 Cluster Autoscaler/Karpenter 扩节点,但要设置上限和预算。
- 缩容尊重 PDB、本地存储、DaemonSet、长连接。
自动扩缩容深水区
HPA
- 依赖 metrics-server(Resource metrics)或 custom/external metrics adapter。
- CPU utilization 需要 requests;没有 requests 无法计算。
- 算法:期望副本 = ceil(当前副本 × 当前指标 / 目标指标)。
- 容忍度默认 10%,避免抖动。
behavior控制 scaleUp/scaleDown 速度和稳定窗口。- 缩容要考虑长连接、冷启动、缓存预热。
- HPA 达到 maxReplicas 要告警。
behavior: |
VPA
- 推荐/自动调整 requests/limits。
- 默认
controlledValues: RequestsAndLimits;只调 requests 用RequestsOnly。 updateMode:Off(只推荐)、Initial、Recreate、InPlaceOrRecreate、InPlace(按版本支持)。- 与 HPA 同时用可能冲突;常见组合是 HPA 用 CPU/自定义指标,VPA 用
Off只做推荐。 - VPA 需要 CRD/组件,不是内置控制器。
Cluster Autoscaler / Karpenter
- 按 Pending Pod 扩容节点。
- 缩容时尊重 PDB、DaemonSet、本地存储、长连接。
- 需要云厂商/node group 集成。
- Karpenter 更灵活(按需选择实例类型、整合节点)。
- 注意节点启动时间、镜像拉取、CNI IP、配额、Spot 中断。
- 设置最大节点数/预算告警,避免成本失控。
- 扩容不是无限:APF/配额/网络/IP 都可能成为瓶颈。
网络与 IPAM
CIDR
- Pod CIDR:每个节点分配 Pod IP 段。
- Service CIDR:ClusterIP 范围。
- 两者不能重叠,也不能和节点/VPC/对端网络重叠。
- 双栈需要 IPv4/IPv6 Pod/Service CIDR。
- 变更 CIDR 很困难,规划时留足地址空间。
CNI 与 kube-proxy
- CNI 负责 Pod 网络、IPAM、NetworkPolicy(取决于插件)。
- kube-proxy 负责 Service 转发;模式有 iptables/IPVS/nftables(按版本/特性)。
- 大规模 Service/Endpoint 下 iptables 规则膨胀,IPVS/nftables 可能更合适。
- CNI 插件要支持 NetworkPolicy、双栈、带宽限制等需求。
- 节点 IP 耗尽会导致 Pending/CNI 失败;监控 IP 使用率。
DNS
- CoreDNS 是默认 DNS;大规模集群要扩容/缓存。
- NodeLocal DNSCache 降低 DNS 延迟和 CoreDNS 压力。
- 默认
ndots:5可能导致大量搜索域查询;按需调整。 - NetworkPolicy 默认拒绝时要放行 DNS egress。
- DNS 故障会放大为全站故障,要有监控和冗余。
入口与负载均衡
- Ingress/Gateway 统一入口,限制 NodePort。
- 云 LoadBalancer 要关注配额、安全组、跨区流量。
- 入口控制器至少 2 副本、PDB、反亲和。
- 证书、WAF、限流、观测统一在入口层做。
存储运维
PV/PVC/StorageClass
- StorageClass 定义动态供给;默认 StorageClass 要明确。
- PVC 绑定 PV;
WaitForFirstConsumer影响调度。 - 扩容需要 StorageClass
allowVolumeExpansion: true和 CSI 支持。 - 快照用 VolumeSnapshot(CSI)。
- 回收策略 Delete/Retain 要按数据重要性设置。
- PV 是集群级资源,不受 Namespace ResourceQuota 直接限制;配额统计 PVC 数量/存储请求。
节点维护与存储
- drain 不会删除 PVC/PV,但会卸载卷。
- 本地存储/emptyDir 数据在 drain/重建时可能丢失。
- 有状态服务要确认多副本/复制/备份。
- CSI 驱动升级要先看兼容矩阵。
- 卷 attach/detach 失败会导致 Pod 卡在 ContainerCreating。
- 备份 etcd 不等于备份 PV;PV 数据要单独快照/备份。
可观测性深水区
指标分层
- 集群/节点:node-exporter、cAdvisor、kubelet。
- Kubernetes 对象:kube-state-metrics。
- 控制面:apiserver、etcd、scheduler、controller-manager。
- 工作负载:应用 metrics、RED/USE。
- 事件/审计:Event、apiserver audit。
- 日志:系统组件 + 业务 + 审计。
关键指标
| 组件 | 指标 |
|---|---|
| 节点 | CPU/内存/磁盘/inode/网络、NotReady |
| kubelet | PLEG、eviction、runtime、证书 |
| apiserver | 5xx、latency、inflight、APF 限流 |
| etcd | leader、fsync、backend commit、DB size、alarm |
| scheduler | pending、scheduling latency、preemption |
| controller | queue depth、reconcile errors |
| HPA | 当前/期望副本、maxReplicas |
| 存储 | PVC 使用率、attach/detach、CSI 错误 |
告警与 SLO
- 节点 NotReady > 5m。
- etcd 无 leader/fsync p99 高/DB 接近 quota。
- apiserver 5xx/限流。
- Pending Pod 持续增长。
- HPA 长期 maxReplicas。
- 证书 < 30 天。
- PVC/inode 使用率 > 80%。
- 入口 5xx/P99。
告警分级:P0 电话,P1 IM/电话,P2 工单;避免所有告警都 page。
灾备与多集群
RTO/RPO
- 先定义业务分级:核心/重要/一般。
- RTO:恢复时间;RPO:可丢数据时间。
- etcd 备份频率决定 RPO;恢复演练决定 RTO 可信度。
备份
- etcd 快照(异地、加密、定期)。
- PVC/VolumeSnapshot。
- GitOps 仓库、Helm values、Kustomize。
- 证书、密钥、镜像、配置。
- 备份恢复要有 runbook 和演练。
集群重建
- 准备基础设施/网络/负载均衡。
- 用 IaC/kubeadm 重建控制面。
- 恢复 etcd 或重新初始化。
- 加入节点/安装 CNI/存储。
- GitOps 恢复工作负载。
- 恢复 PV/数据。
- 验证 DNS/证书/入口/关键业务。
多集群
- 按环境/区域/租户/合规拆分。
- 多集群 DNS、证书、网络、流量切换。
- Cluster API/Karmada/Fleet 管理集群生命周期。
- 避免“多集群但共享 etcd/网络”的伪隔离。
- 跨集群数据复制与一致性要单独设计。
联邦集群与多集群
概念边界
- 多集群:管理多个 Kubernetes 集群,可能只是独立集群 + GitOps + 统一观测。
- 联邦(Federation):在多个集群之上增加控制面,按策略把资源传播/调度到成员集群,并提供覆盖、故障迁移、状态聚合。
- 集群生命周期:创建/升级/扩缩/删除集群,典型是 Cluster API。
- 跨集群网络:让不同集群的 Pod/Service 互通,典型是 Submariner、Cilium ClusterMesh、Istio 多集群。
联邦不是 Kubernetes 内置能力。Kubernetes 早期的 Federation v1 已移除,KubeFed(Federation v2)仓库已归档到 kubernetes-retired/kubefed,不再活跃开发。新项目不要把 KubeFed 作为基础。
联邦 vs 独立多集群
| 需求 | 建议 |
|---|---|
| 环境隔离、租户隔离 | 独立集群 + GitOps,不一定需要联邦 |
| 同一应用多地部署、统一策略 | 联邦控制面(Karmada/OCM) |
| 多集群 GitOps 分发 | Argo CD ApplicationSet、Flux、Fleet |
| 集群生命周期管理 | Cluster API |
| 跨集群 Pod/Service 网络 | Submariner、Cilium ClusterMesh、Istio |
| 跨云算力共享/卸载 | Liqo、Karmada/OCM |
| 强合规/强隔离 | 独立集群/独立控制面,慎用共享联邦控制面 |
控制面与数据面
Federation Control Plane |
- 控制面保存期望状态和策略。
- 成员集群是数据面,实际运行工作负载。
- 控制面故障不应导致已有工作负载停止;但新的传播、调度、故障迁移会暂停。
- 控制面是新的高价值目标:必须 HA、备份、审计、网络隔离。
Push vs Pull
| 模式 | 说明 | 优点 | 缺点 |
|---|---|---|---|
| Push | 控制面持有成员集群 kubeconfig,直接创建资源 | 实现简单、状态实时 | 控制面需要网络可达;凭据集中 |
| Pull | 成员集群 agent 监听控制面,拉取 Work | 适合私有/边缘/NAT;凭据分散 | 需要 agent;状态延迟 |
选择:
- 成员集群在公网/私有网络、控制面无法主动访问 → Pull。
- 同一可信网络、希望简单 → Push。
- 混合:核心集群 Push,边缘集群 Pull。
Karmada
Karmada 是 CNCF incubation 项目,明确继承 Federation v1/v2 的概念。
控制面
Karmada 控制面包含:
- Karmada API Server
- Karmada Controller Manager
- Karmada Scheduler
- etcd
控制器大致负责:
- Cluster Controller:注册/管理成员集群。
- Policy Controller:监听 PropagationPolicy,选择资源并创建 ResourceBinding/ClusterResourceBinding。
- Scheduler:为 Binding 选择成员集群。
- Binding/Execution Controller:生成 Work,下发到成员集群。
- Status Controller:聚合成员集群状态。
资源传播
Resource Template(Deployment/Service/...) |
PropagationPolicy 通过 resourceSelectors 选择资源,通过 placement 选择集群:
clusterAffinity.clusterNames/exclude- label/field selector
- cluster taints/tolerations
- spread constraints
- replica scheduling:Duplicated、Divided(Aggregated/Weighted)
- dynamic division/rebalancing
Override
OverridePolicy / ClusterOverridePolicy 用于按集群差异化:
- 镜像 registry/repository/tag
- replicas
- resources
- env/command/args
- labels/annotations
- storageClass、ingress host 等
原则:
- 差异化只放必要项,避免每集群一份雪flake。
- Override 规则要可审计、可测试。
- 不要用 Override 绕过安全/合规基线。
故障迁移
- 成员集群可打 taint(
NoSchedule/NoExecute)。 - Placement 通过 toleration 决定是否容忍。
- 集群不可达/不健康时,调度器可按策略重新分配副本。
- 有状态服务要额外做 fencing、数据一致性、主备切换,不能只靠调度器。
依赖与状态
- 依赖资源(Namespace、CRD、RBAC、ConfigMap、Secret)要按顺序传播。
propagateDeps等能力可传播依赖,但要确认版本/行为。ResourceBinding/Work的状态要能反映“已下发/已应用/健康”。- 成员集群手工修改会造成 drift,需要 reconcile/override/告警。
适用与限制
适合:
- 多集群无状态应用分发、灰度、双活/异地部署。
- 统一 placement/override/故障迁移策略。
- 多集群 API 兼容,不希望改应用。
限制:
- 跨集群网络/服务发现需要额外方案。
- 有状态数据、跨集群事务仍需单独设计。
- 控制面 HA/备份/升级是新的运维负担。
- 成员集群版本/CRD 兼容性要管理。
Open Cluster Management(OCM)
OCM 是 CNCF sandbox 项目,核心是 Hub/Spoke:
- Hub 集群保存
ManagedCluster、Placement、ManifestWork、Policy、addon 等。 - 成员集群运行
Klusterletagent。 - 能力:集群注册、工作负载分发、动态 placement、策略治理、addon 管理。
适合:
- 多集群治理、边缘、跨云。
- 需要把“集群注册 + 分发 + 策略 + addon”拆成可组合 API。
- 与 Argo CD、Helm、Cluster API、Submariner 等集成。
注意:
- 需要自己组合应用生命周期/网络/观测。
- Hub 是控制面单点,要做 HA/备份。
- Placement/ManifestWork 的语义和清理策略要设计好。
Rancher Fleet
Fleet 是 Rancher 生态的 GitOps 多集群分发工具:
GitRepo:Git 仓库源。Bundle:渲染后的资源包。BundleDeployment:向目标集群部署。ClusterGroup:集群分组。- 支持 Helm/Kustomize、target customizations、drift 检测、分片。
适合:
- GitOps 驱动的多集群应用分发。
- 边缘/Rancher 管理集群。
- 不需要复杂跨集群调度/故障迁移。
注意:
- 它更偏“GitOps 分发”,不是完整联邦调度器。
- 多集群 placement/override 能力取决于 Fleet 的 target customization。
- 需要设计 repo/集群分组/密钥分发。
Cluster API
Cluster API 是 Kubernetes SIG Cluster Lifecycle 项目,管理集群生命周期:
- Management Cluster 管理 Workload Cluster。
- Provider:Infrastructure、Bootstrap、ControlPlane。
- 资源:
Cluster、Machine、MachineDeployment、MachineSet、KubeadmControlPlane、ClusterClass。 - 能力:创建、升级、扩缩、修复、删除集群。
它不负责应用跨集群调度/传播。常见组合:
- Cluster API 管理集群生命周期。
- Karmada/OCM/Fleet 分发应用。
- Submariner/Cilium/Istio 提供跨集群网络。
跨集群网络
联邦控制面不会自动让 Pod 互通。常见方案:
| 方案 | 层次 | 能力 |
|---|---|---|
| Submariner | L3 | Pod/Service 跨集群互通,IPsec/WireGuard,Lighthouse DNS |
| Cilium ClusterMesh | L3/L4 | eBPF 网络、全局 Service、NetworkPolicy |
| Istio 多集群 | L7 | mTLS、服务发现、流量治理、跨集群 gateway |
| Liqo | 多集群 peering | 资源卸载、虚拟节点、网络 fabric |
| Ingress/Gateway | L7 | 通过公网/专线暴露服务,不做 Pod 直连 |
关键约束:
- Pod/Service CIDR 不能重叠;重叠时用 Submariner Globalnet、Cilium 方案或 NAT。
- MTU、加密开销、跨地域延迟。
- DNS/服务发现:Lighthouse、ClusterMesh global service、Istio service entry。
- NetworkPolicy 是否跨集群生效,取决于方案。
- 跨集群网络不是身份认证,仍需 mTLS/授权。
身份与安全
- 集群注册凭据是最高价值目标:Push 模式控制面持有 kubeconfig;Pull 模式 agent 持有 token。
- 最小权限:每个成员集群使用独立凭据,限制 namespace/resource/verb。
- 控制面启用 mTLS、RBAC、审计、Secret 加密、网络隔离。
- 成员集群的 admission/RBAC 仍然生效;Work 以控制器身份应用,必须限制其权限。
- 跨集群工作负载身份:SPIFFE/OIDC、service mesh mTLS、云 Workload Identity。
- Secret 分发:External Secrets/Vault/Sealed Secrets;不要明文进 Git。
- 多租户:集群级隔离 vs namespace 级隔离;联邦控制面本身也要租户边界。
数据与一致性
- 无状态应用最适合联邦:镜像/配置/Service 分发即可。
- 有状态应用要单独设计:
- 数据复制(数据库原生、存储复制、Operator)。
- 主备/双活、fencing、quorum。
- RPO/RTO、跨区域延迟、冲突解决。
- PVC/StorageClass/拓扑感知。
- 不要假设调度器能解决数据一致性。
- 全局数据库 vs 每集群本地库:前者延迟/可用性代价高,后者冲突/迁移复杂。
- 配置/Secret 的跨集群一致性要有版本和审计。
资源传播、依赖与 GC
传播顺序:
- Namespace
- CRD/Controller
- RBAC/ServiceAccount
- StorageClass/NetworkPolicy/Config
- Secret/ConfigMap
- Workload/Service/Ingress
需要明确:
- Owner:控制面还是成员集群拥有资源?
- GC:删除策略时,成员集群资源删除还是保留(orphan)?
- Adoption:成员集群已有同名资源,接管还是冲突?
- Drift:成员集群手工修改是否纠正?是否告警?
- Cluster removal:优雅驱逐、强制清理、保留数据。
- Finalizer:删除顺序、失败重试、孤儿资源清理。
Placement 与 Override 设计
Placement 维度:
- 地域/可用区/环境/租户/云厂商。
- 容量/资源/GPU/Spot。
- 集群健康/版本/标签/taint。
- 副本分布:Duplicated、Divided、Weighted、Spread。
- 故障迁移:健康检查、grace period、避免抖动。
Override 维度:
- 镜像 registry(跨云/跨区域)。
- replicas/资源(容量差异)。
- StorageClass/Ingress/DNS。
- 环境变量/特性开关。
- 合规/加密配置。
原则:
- 默认策略统一,例外显式 override。
- Override 要可审计、可测试、可回滚。
- 不要让每个集群变成独立雪flake。
- 用标签/策略而不是复制多份 YAML。
故障迁移与 split-brain
- 集群健康检测:心跳、conditions、taint、Work 状态。
- 故障迁移:重新调度副本、切流量、提升备库。
- 避免 flapping:grace period、连续失败阈值、人工确认。
- 网络分区:成员集群可能仍在运行但控制面失联;不要立即删除/重建。
- 双控制面/双写:必须有 fencing/ownership,避免两个控制面同时写。
- 有状态迁移:先 fencing 旧主,再提升新主,再切流量。
- 控制面故障:已有工作负载继续运行;变更/调度暂停;恢复控制面后 reconcile。
GitOps 与联邦
两种模式:
- 纯 GitOps:Argo CD/Flux/Fleet 把同一份/多份 overlay 推到各集群;没有跨集群调度。
- 联邦 + GitOps:GitOps 管理控制面资源(PropagationPolicy/Override/Placement),联邦控制器负责下发。
注意:
- 避免双重 ownership:GitOps 和联邦同时管理同一成员资源会打架。
- GitOps 管控制面,联邦管成员集群;或 GitOps 直接管成员,联邦只做策略。
- Secrets 用 External Secrets/SOPS/Sealed Secrets。
- 环境晋升用 overlay/PR,不要手工改集群。
- 观测 GitOps 同步状态 + 联邦 Work 状态。
观测与运维
控制面指标:
- API 延迟/错误。
- Work queue、reconcile 错误、调度延迟。
- Binding/Work 成功/失败。
- 成员集群心跳/conditions。
- 策略拒绝/冲突。
- 控制面 etcd/证书/资源。
成员集群:
- Work 是否 applied/available/healthy。
- 资源 drift。
- 集群版本/容量/网络。
- 应用 SLO。
告警:
- 成员集群不可达。
- Work 长时间未 ready。
- Placement 失败/无候选集群。
- 控制面 etcd/证书/leader 异常。
- 版本偏差/CRD 不兼容。
- 故障迁移失败/重复迁移。
方案对比
| 方案 | 定位 | 应用放置/故障迁移 | 网络 | 适用 |
|---|---|---|---|---|
| Karmada | 应用联邦 | 强,Policy/Binding/Override/Failover | 需另配 | 多集群应用分发、双活/DR |
| OCM | Hub/Spoke 多集群治理 | Placement/ManifestWork/Policy | 需另配 | 多集群治理、边缘、addon |
| Fleet | GitOps 多集群分发 | 以分发为主 | 需另配 | Rancher/边缘 GitOps |
| Cluster API | 集群生命周期 | 不做应用放置 | 不提供 | 集群创建/升级/扩缩 |
| Submariner | 跨集群 L3 | 不做应用放置 | 强 | Pod/Service 互通 |
| Cilium ClusterMesh | 跨集群网络/策略 | 不做应用放置 | 强 | eBPF 多集群网络 |
| Istio 多集群 | 服务网格 | 流量治理强 | L7 | mTLS/跨集群流量 |
| Liqo | Peering/卸载 | 资源卸载 | 有 | 算力共享/边缘 |
| KubeFed | 已归档 | 不活跃 | - | 不建议新项目 |
设计决策与反模式
先问:
- 真的需要联邦,还是独立集群 + GitOps?
- 成员集群网络是否互通?CIDR 是否冲突?
- 有状态数据怎么复制/切换?
- 谁拥有资源?删除时保留还是清理?
- 控制面故障时,现有业务是否继续?
- 故障迁移会不会造成双写/脑裂?
- 团队能否运维新的控制面?
反模式:
- 用联邦解决所有多集群问题。
- 控制面单点、无备份。
- Push 模式给控制面 cluster-admin kubeconfig。
- 成员集群 CIDR 重叠还强行互联。
- 有状态应用直接跨集群调度,不做数据方案。
- 自动故障迁移没有 fencing。
- GitOps 和联邦双重管理同一资源。
- 每个集群一份手工 override,长期漂移。
- 删除策略不明确,孤儿资源/误删。
- 不做版本/CRD 兼容性管理。
- 不做故障迁移演练。
落地路线
- 明确目标:DR、双活、多云、边缘、租户隔离。
- 盘点集群、网络 CIDR、身份、数据、合规。
- 选择模型:GitOps-only、Karmada、OCM、Fleet、CAPI + 网络。
- 建控制面:HA、备份、审计、监控。
- 注册成员集群:最小权限、凭据轮换。
- 设计 placement/override/ownership/GC。
- 打通网络/身份/Secret。
- 先无状态应用试点,做故障迁移演练。
- 再有状态数据/DR 方案。
- 建立观测、告警、runbook、升级策略。
联邦检查清单
- 明确联邦 vs 多集群 GitOps 的边界
- 控制面 HA、备份、恢复演练
- 成员集群注册凭据最小权限/轮换
- Push/Pull 模式与网络可达性匹配
- Placement 策略覆盖地域/容量/故障域
- Override 只用于必要差异,可审计
- Namespace/CRD/RBAC/Secret 依赖顺序
- 资源 ownership/GC/删除策略明确
- 跨集群 CIDR 不冲突,网络/加密/DNS 就绪
- 成员集群 RBAC/admission 仍然生效
- 有状态数据复制/fencing/RPO/RTO
- 故障迁移不双写、不脑裂、有 grace period
- GitOps 与联邦 ownership 不冲突
- Work/Placement/控制面指标可观测
- 版本/CRD 兼容矩阵
- 故障迁移、控制面故障、成员失联演练
故障案例与排查
节点 NotReady
systemctl status kubelet |
检查:
- kubelet 证书/配置。
- 容器运行时/CRI。
- CNI。
- 磁盘/inode/内存/PID 压力。
- apiserver 连通性/VIP/LB。
- 节点时间同步。
- cgroup v2。
Pending
- 资源不足(requests)。
- 污点/亲和性/拓扑。
- PVC 未绑定/StorageClass 不存在。
- 节点 NotReady。
- maxPods/IP 耗尽。
- ResourceQuota 会在创建阶段 Forbidden,不是 Pending。
- PDB 不影响调度。
频繁驱逐/OOM
- 节点压力阈值。
- Pod requests/limits 不合理。
- QoS/优先级。
- 内存泄漏/大页/缓存。
kubectl describe node看 Events/Allocated resources。- 检查
kubelet_evictions、OOMKilled、restart count。
升级失败
- 版本跨度/版本偏差。
- 已移除 API。
- cgroup v1。
- 证书过期/SAN 不匹配。
- CNI/CRI 不兼容。
- etcd 不健康/quorum 丢失。
- 重跑
kubeadm upgrade;检查/etc/kubernetes/tmp备份;必要时从 etcd 快照恢复。 - Kubernetes 不支持 minor 降级,回滚以重建/应用回滚为主。
etcd 故障
- 无 leader/quorum。
- WAL fsync 高/磁盘慢。
- DB 接近 quota/NOSPACE。
- 成员磁盘损坏。
- 恢复顺序:恢复 quorum → 替换成员 → 恢复快照。
- 不要盲目删除 data-dir 或重建集群。
DNS/网络
- CoreDNS 副本/资源不足。
- NetworkPolicy 阻断 DNS/入口。
- CNI IP 耗尽。
- kube-proxy/Service 规则异常。
- 节点 MTU/overlay 问题。
- 用
dig/nslookup/curl/tcpdump分层排查。
生产检查清单
控制面
- 3 个控制面,跨故障域,反亲和
- apiserver 前有 LB/VIP,健康检查
- 证书 SAN 包含 VIP/所有控制面地址
- controller-manager/scheduler leader election 正常
- apiserver 不暴露公网
- 审计/加密/NodeRestriction/PSA 开启
etcd
- 3/5 成员,奇数 quorum
- 专用 SSD,低 fsync 延迟
- TLS + client cert auth
- 定期快照 + 异地加密
- compaction/defrag/quota/alarm 监控
- 成员替换/恢复演练
证书
-
kubeadm certs check-expiration纳入监控 - 叶子证书到期告警 < 30 天
- kubelet 客户端证书自动轮换
- 外部 CA/CSR 流程明确
- 私钥权限/备份/轮换
升级
- 一次一个 minor
- 版本偏差符合策略
- 升级前 etcd 备份/API 扫描/cgroup v2
- 控制面 → kubelet → 工作负载
- drain 遵守 PDB/容量
- 升级后验证 CNI/CoreDNS/Ingress/存储/业务
- 回滚/恢复 runbook
调度与容量
- requests/limits 全覆盖
- QoS/优先级/PDB 合理
- 节点池按业务/硬件/Spot 拆分
- headroom/故障切换容量
- IP/maxPods/CIDR 规划
- HPA/VPA/CA 不冲突,设置上限
网络与存储
- Pod/Service CIDR 不重叠,留足地址
- CNI 支持 NetworkPolicy/双栈
- CoreDNS 冗余/缓存
- 入口统一,限制 NodePort
- StorageClass/CSI/快照/扩容
- 本地存储/emptyDir 维护策略
可观测性
- 节点/控制面/etcd/工作负载指标
- 日志/事件/审计接入
- SLO/告警分级
- 证书/PVC/IP/配额告警
- Dashboard/Runbook
灾备
- RTO/RPO 明确
- etcd/PV/GitOps/密钥备份
- 恢复顺序和 runbook
- 节点/控制面/可用区故障演练
- 多集群 DNS/流量切换