


混沌工程不是“随机搞破坏”,而是用受控实验验证系统在真实故障下是否还能守住 SLO。本文按 Principles of Chaos、Google SRE、Chaos Mesh、ChaosBlade、LitmusChaos 的官方资料,讲清实验设计、故障类型、工具选型、生产安全、Game Day、自动化和组织治理。
最后更新:2026-10-22
- 什么是混沌工程
- 五个核心原则
- 混沌工程与相关实践的区别
- 成熟度模型
- 实验设计方法
- 稳态指标
- 故障类型全景
- 工具选型
- Kubernetes 实验实战
- 生产环境安全
- Game Day
- 故障演练矩阵
- 可观测性要求
- 自动化与 CI/CD
- 度量体系
- 组织与治理
- 常见反模式
- 模板
- 案例
- 附录
什么是混沌工程
Principles of Chaos 的定义:
Chaos Engineering is the discipline of experimenting on a system in order to build confidence in the system’s capability to withstand turbulent conditions in production.
翻译:混沌工程是对系统做实验,以建立“系统能在生产环境动荡条件下存活”的信心。
关键词:
- 实验:不是随机破坏,而是有假设、有观测、有结论
- 信心:目标是减少未知,不是制造事故
- 生产条件:真实流量、真实依赖、真实配置
- 受控:有范围、有中止条件、有回滚
混沌工程解决的是分布式系统的“未知未知”:
- 单服务都正常,但服务间交互导致级联失败
- 超时/重试配置不当导致重试风暴
- 下游变慢导致线程池耗尽
- 单点故障导致雪崩
- 故障转移没演练过,真出事时切不过去
它不是:
- 随机杀 Pod 的“破坏性测试”
- 只做一次就结束的演练
- 用生产事故来“验证”系统
- 替代单元/集成/压测/灾备演练
五个核心原则
1. 围绕稳态建立假设
先定义“系统正常”是什么:
- 成功率、延迟、错误率
- 数据新鲜度
- 队列 lag
- SLO/错误预算
然后提出可证伪的假设:
在注入 100ms 网络延迟、持续 5 分钟的情况下,核心下单接口成功率仍 ≥ 99.9%,P95 延迟 < 500ms。
没有稳态指标和假设,就不是实验。
2. 变化真实世界事件
故障变量要对应真实事件:
- 服务器宕机
- 磁盘满
- 网络分区/延迟/丢包
- DNS 故障
- 依赖超时
- 流量突增
- 证书过期
- 可用区故障
按“影响大”或“发生频率高”排序,不要只做最简单的 Pod kill。
3. 在生产环境做实验
系统的行为依赖真实流量、真实数据和真实依赖。预发环境很难复制:
- 流量模式
- 数据规模和分布
- 网络拓扑
- 依赖的真实延迟
- 配置漂移
生产实验必须配合最小爆炸半径、审批、监控和中止条件。不能一上来就全量。
4. 自动化实验以持续运行
一次性演练会过期。系统、流量、依赖都在变,实验要:
- 定期调度
- 进入 CI/CD
- 自动判定成功/失败
- 自动恢复
- 结果可追踪
Chaos Mesh 的 Schedule、Workflow、StatusCheck 就是为持续实验设计的。
5. 最小化爆炸半径
生产实验可能造成真实影响,必须:
- 只选少量实例/租户/流量
- 设置短持续时间
- 明确中止条件
- 有 kill switch
- 通知 on-call 和业务
- 从非核心业务开始
原则不是“必须炸生产”,而是“在生产中学习,同时把影响控制在可接受范围”。
混沌工程与相关实践的区别
| 实践 | 目的 | 范围 | 是否有假设 | 典型产出 |
|---|---|---|---|---|
| 单元/集成测试 | 验证代码逻辑 | 开发/CI | 是 | 测试报告 |
| 故障注入 | 注入一个故障 | 组件/环境 | 不一定 | 故障行为 |
| 混沌实验 | 验证系统在故障下的稳态 | 受控范围 | 是 | 假设是否成立 |
| 压测 | 找容量上限 | 环境/生产 | 是 | 容量曲线 |
| Game Day | 组织级演练 | 多团队 | 是 | 协作和恢复能力 |
| 灾备演练 | 验证 RTO/RPO | 机房/区域 | 是 | 恢复报告 |
| 混沌工程 | 持续建立系统韧性信心 | 组织级 | 是 | 实验体系和文化 |
混沌工程可以包含故障注入、压测、Game Day、灾备演练,但不等同于其中任何一个。
成熟度模型
| 阶段 | 特征 | 风险 |
|---|---|---|
| L0 手工故障注入 | 手动杀 Pod、断网 | 高,难复现 |
| L1 预发实验 | 预发环境跑固定场景 | 低,但真实性不足 |
| L2 生产小范围 | 生产 canary 租户/实例 | 中,需要 guardrail |
| L3 持续实验 | 定时/流水线自动实验 | 中,需要自动化判定 |
| L4 混沌即代码 | GitOps 管理实验、CI 门禁 | 低,可审计 |
| L5 组织韧性 | 多团队 Game Day、灾备、持续改进 | 低,形成文化 |
不要跳级。没有可观测性、SLO 和中止机制,直接做生产混沌会把故障放大。
实验设计方法
实验文档
每个实验至少写清:
- 实验名称、owner、日期
- 目标服务和依赖
- 稳态指标和基线
- 假设
- 故障类型和参数
- 影响范围(namespace/label/流量比例)
- 持续时间
- 中止条件
- 回滚/恢复步骤
- 通知对象
- 观测看板
- 结果和 action
设计步骤
- 选目标:核心链路、最近故障、高风险依赖
- 定稳态:SLI/SLO、错误率、延迟、lag、数据新鲜度
- 写假设:可证伪,例如“P95 延迟不会超过 500ms”
- 选故障:对应真实事件,不要为了工具而工具
- 定范围:从 1 个实例/1 个租户/5% 流量开始
- 定时间:短、可中止、避开高峰
- 准备观测:看板、告警、日志、trace
- 准备恢复:kill switch、回滚、扩容、切流
- 执行:记录开始/结束、注入参数、观察结果
- 复盘:假设是否成立、系统哪里弱、action 是什么
中止条件
- SLO 跌破阈值
- 错误率/延迟超过红线
- 影响范围超出预期
- 出现数据丢失/安全事件
- on-call 无法及时响应
- 业务方要求停止
中止条件要在实验前写死,不能临场“再看看”。
实验分级
| 级别 | 范围 | 示例 |
|---|---|---|
| 组件级 | 单 Pod/单实例 | 杀一个 Pod |
| 服务级 | 单服务/单租户 | 服务网络延迟 |
| 依赖级 | 数据库/缓存/MQ | 主库切换、Redis 超时 |
| 区域级 | AZ/机房 | 可用区故障 |
| 组织级 | 多团队/多系统 | Game Day、灾备 |
稳态指标
黄金信号
- Latency:P50/P95/P99
- Traffic:QPS、吞吐
- Errors:错误率、失败请求
- Saturation:CPU、内存、磁盘、连接池、队列
SLO 指标
- 可用性
- 请求成功率
- 数据新鲜度
- 作业 SLA 完成率
- 消费 lag
业务指标
- 下单成功率
- 支付成功率
- 登录成功率
- 核心报表按时率
基线
实验前至少采集:
- 最近 1 小时/1 天的基线
- 同时段对比
- 依赖的健康状态
- 容量水位
没有基线,就无法判断“变慢”是实验导致还是正常波动。
故障类型全景
资源类
- CPU 打满
- 内存耗尽/OOM
- 磁盘满/inode 耗尽
- 磁盘 IO 延迟/错误
- 文件系统只读
- 线程池/连接池耗尽
网络类
- 延迟
- 丢包
- 重复包
- 乱序
- 带宽限制
- 网络分区
- DNS 解析失败/错误
- TLS 握手失败
- 端口不可达
进程/容器类
- 杀 Pod
- 容器重启
- 容器 OOM
- 镜像拉取失败
- 进程暂停
- 信号错误
节点类
- 节点宕机
- 节点 drain
- kubelet 故障
- 容器运行时故障
- 内核 panic
- 时钟偏移
中间件类
- 数据库主库切换
- 从库延迟
- 连接数耗尽
- 缓存击穿/雪崩
- 消息队列分区不可用
- 消费者 lag
- 锁冲突/死锁
云与基础设施
- 可用区故障
- 负载均衡故障
- 对象存储限流
- 网络 ACL/安全组错误
- 证书过期
- IAM 权限失效
数据类
- 数据损坏
- 数据重复
- 数据延迟
- schema 不兼容
- 分区丢失
安全类
- 证书过期
- Kerberos/Token 失效
- 权限拒绝
- 密钥轮换失败
- 审计中断
工具选型
Chaos Mesh
版本:2.8.x(当前 2.8.6)
特点:
- Kubernetes CRD:PodChaos、NetworkChaos、StressChaos、IOChaos、DNSChaos、TimeChaos、HTTPChaos、KernelChaos、JVMChaos、云厂商 Chaos 等
- 组件:Chaos Dashboard、Chaos Controller Manager、Chaos Daemon(DaemonSet,默认 privileged)
- Workflow/Schedule/StatusCheck 支持编排和持续实验
- 适合 Kubernetes 原生、GitOps、多集群
注意:
- Chaos Daemon 权限较高,必须限制 namespace/RBAC
- 默认 privileged,生产要评估安全边界
- 网络/内核故障依赖节点权限
ChaosBlade
版本:1.8.x(当前 1.8.2)

图 1:ChaosBlade 官方整体架构
特点:
- 阿里开源,CLI + chaosblade-box 平台
- 支持主机、容器、Kubernetes、多语言(Java/Go/C++ 等)
- 故障类型丰富,适合混合环境
- 学习曲线比 Chaos Mesh 稍高
LitmusChaos
版本:3.33.0
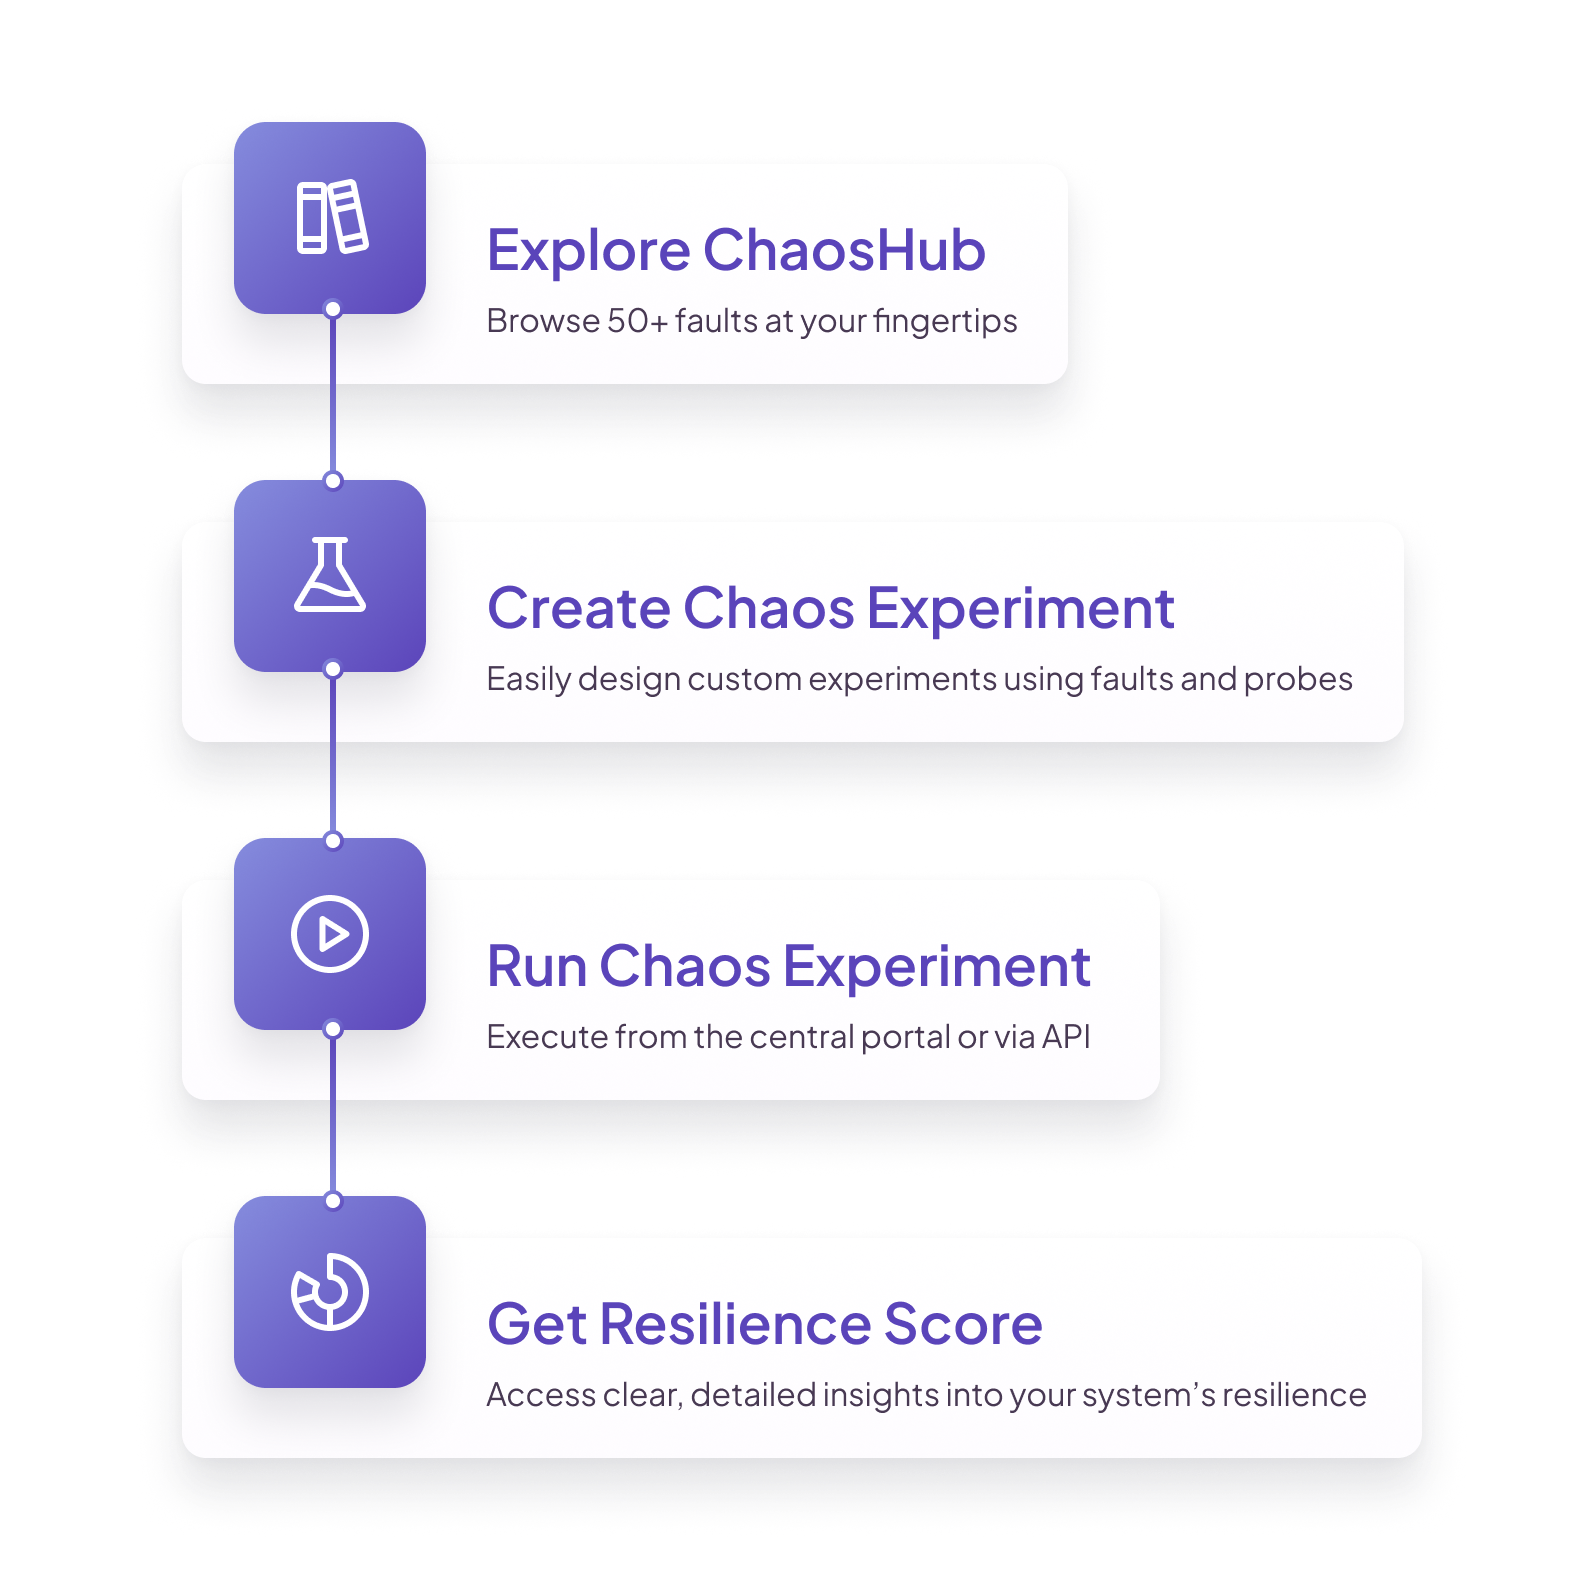
图 2:LitmusChaos 官方概览
特点:
- CNCF 托管
- ChaosHub、实验模板、Workflow、Probes
- 适合 Kubernetes、GitOps、CI/CD
- 有商业版和社区版
其他
- Chaosd:物理机/节点级故障注入
- AWS FIS:AWS 资源级故障注入
- Gremlin:商业混沌工程平台
- 自研:脚本/Operator,适合特定场景
选型对比
| 工具 | 范围 | 优势 | 注意 |
|---|---|---|---|
| Chaos Mesh | Kubernetes | CRD、Workflow、生态好 | Daemon 权限高 |
| ChaosBlade | 主机/容器/K8s | 故障类型多、混合环境 | 平台化需额外建设 |
| LitmusChaos | Kubernetes | CNCF、ChaosHub、Probes | 实验模板需维护 |
| AWS FIS | AWS | 云资源原生 | 绑定 AWS |
| Gremlin | 商业 | 托管、易用 | 成本 |
Kubernetes 实验实战
安装 Chaos Mesh
helm repo add chaos-mesh https://charts.chaos-mesh.org |
生产要固定版本、限制 RBAC、配置资源限制和 NetworkPolicy。
Pod Kill
apiVersion: chaos-mesh.org/v1alpha1 |
网络延迟
apiVersion: chaos-mesh.org/v1alpha1 |
网络分区
apiVersion: chaos-mesh.org/v1alpha1 |
CPU/内存压力
apiVersion: chaos-mesh.org/v1alpha1 |
DNS 故障
apiVersion: chaos-mesh.org/v1alpha1 |
Workflow 编排
apiVersion: chaos-mesh.org/v1alpha1 |
生产环境安全
生产实验的底线:影响可控、可观测、可中止、可回滚。
Guardrail
- 只允许指定 namespace/label
- 禁止选择 kube-system、chaos-mesh、监控、etcd、Ingress 等关键组件
- 设置最大持续时间、最大影响实例数
- 生产实验必须审批
- 实验期间 on-call 必须在岗
- 有 kill switch
- 有业务方确认
权限
- Chaos 工具使用独立 ServiceAccount
- 最小 RBAC,只允许目标 namespace/resource
- 限制 CRD 创建权限
- 审计所有实验创建/删除
爆炸半径
- 从 1 个实例开始
- 用 canary 租户/流量
- 避开高峰和大促
- 设置短持续时间
- 先做只读/低风险故障
中止与恢复
- 中止条件写进实验文档
- 一键停止/删除 Chaos 资源
- 确认恢复:Pod 重建、网络恢复、数据一致
- 观察 SLO 回到基线
不要做的事
- 在生产随机杀节点
- 对控制面/存储核心组件做未演练的故障
- 没有监控就注入
- 没有回滚就注入
- 用混沌实验“惩罚”团队
Game Day
Game Day 是组织级故障演练,不只是技术注入。
目标
- 验证跨团队协作
- 验证监控、告警、on-call
- 验证 runbook 和升级路径
- 验证故障转移和恢复
- 发现流程和组织问题
角色
- Coordinator:整体计划和安全
- Incident Commander:事故指挥
- Ops Lead:执行恢复
- Comms Lead:沟通
- Scribe:记录
- Observers:业务/安全/管理层
流程
- 选题和范围
- 写场景和假设
- 准备监控、runbook、回滚
- 通知参与方
- 注入故障
- 观察、沟通、恢复
- 复盘和 action
场景示例
- 核心服务 Pod 全部被杀
- 数据库主库切换
- 可用区故障
- DNS 故障
- 证书过期
- Kafka 分区不可用
- HDFS NameNode 切换
复盘
- 时间线
- 检测时间、响应时间、恢复时间
- 哪些告警有效/无效
- runbook 是否准确
- 协作问题
- action item 和 owner
故障演练矩阵
| 层级 | 场景 | 验证点 |
|---|---|---|
| Pod | 杀 Pod、OOM、镜像拉取失败 | 重启、探针、PDB |
| Service | 网络延迟/丢包/分区、DNS 失败 | 超时、重试、熔断、降级 |
| Node | drain、宕机、kubelet 故障 | 迁移、PDB、容量 |
| 依赖 | DB 主从切换、Redis 超时、MQ 不可用 | 连接池、重试、降级 |
| 区域 | AZ 故障 | 多活、DNS 切流、RTO/RPO |
| 平台 | NameNode/RM/Kafka Controller/ZK Leader | HA 切换、客户端恢复 |
| 安全 | 证书过期、Token 失效 | 告警、轮换、恢复 |
| 数据 | 数据损坏、重复、延迟 | 校验、补偿、恢复 |
Hadoop 平台的具体演练项可参考《Hadoop大数据平台运维》中的 NameNode/DataNode/RM/RegionServer/Kafka/ZK 演练。
可观测性要求
没有可观测性,混沌实验就是“盲炸”。
实验前
- 基线:延迟、错误率、吞吐、容量
- 看板:服务、依赖、基础设施
- 告警:SLO burn rate、错误率、延迟、lag
- Trace:关键链路
- 日志:错误、超时、重试
实验中
- 标记实验开始/结束
- 记录注入参数和目标
- 观察 SLO、错误率、延迟、饱和度
- 观察依赖和下游
- 记录异常和恢复动作
实验后
- 对比基线
- 确认恢复
- 归档实验记录
- 更新 runbook 和监控
告警处理
实验期间可以临时调整告警,但不要完全静音:
- 保留 SLO/业务告警
- 抑制已知的实验噪音
- 确保真实故障仍能触发
自动化与 CI/CD
混沌即代码
- 实验定义进 Git
- 通过 GitOps 部署
- 版本化、可审计、可回滚
- 代码评审实验范围和风险
流水线
- 预发:每次发布后跑基础实验
- 生产:定时/灰度跑低风险实验
- 灾备:定期跑切换/恢复
- 结果自动判定,失败阻断发布
调度
- Chaos Mesh
Schedule - Litmus Workflow
- CI cron
- 避开业务高峰
防止“自动化事故”
- 实验有最大范围/时长
- 有 kill switch
- 有审批和审计
- 失败自动停止
- 不要在没有监控的环境自动跑
度量体系
实验覆盖
覆盖率 = 有混沌实验的核心服务数 / 核心服务总数 |
按服务、依赖、故障类型分别看。
故障响应
- 检测时间(MTTD)
- 响应时间
- 恢复时间(MTTR)
- SLO 影响
- 错误预算消耗
实验效果
- 假设成立率
- 发现问题数
- action 完成率
- 复发率
- 事故数量/严重度趋势
不要用的指标
- 实验次数(容易刷)
- 注入故障数(不看价值)
- “杀了多少 Pod”
- 用实验数量排名团队
组织与治理
团队模型
- SRE/平台团队负责工具、标准、guardrail
- 业务团队负责自己的实验和修复
- 安全团队审查权限和高风险实验
- 管理层支持时间和资源
风险分级
| 级别 | 范围 | 审批 |
|---|---|---|
| 低 | 预发/单实例 | 团队自审 |
| 中 | 生产 canary | SRE + 业务 |
| 高 | 核心链路/区域 | 平台负责人 + 业务负责人 |
| 极高 | 控制面/全量 | 变更委员会 |
文化
- 复盘无指责
- 鼓励主动发现问题
- 不把实验失败当绩效问题
- 把 action 跟踪到底
- 共享故障案例
常见反模式
- 没有假设,直接杀 Pod
- 没有稳态指标
- 没有中止条件
- 生产实验不通知
- 没有监控和 trace
- 只做 Pod kill,不做网络/依赖/区域
- 实验后不修复
- 自动化没有 guardrail
- 用混沌实验惩罚团队
- 把 Game Day 做成表演
- 只做一次,不做持续实验
模板
实验文档模板
实验名称: |
Game Day Runbook
目标: |
复盘模板
标题: |
案例
案例 1:Pod Kill 验证高可用
- 假设:杀掉 1 个 web Pod,成功率仍 ≥ 99.9%
- 注入:PodChaos pod-kill,mode one
- 观察:Service Endpoint 摘除、Pod 重建、错误率
- 结果:成功率短时下降到 99.5%,1 分钟后恢复
- 改进:增加 readinessProbe、PDB、预热
案例 2:数据库网络延迟
- 假设:DB 延迟 100ms,接口 P95 < 500ms
- 注入:NetworkChaos delay
- 观察:连接池、超时、重试、熔断
- 结果:连接池耗尽,P95 超过 2s
- 改进:调连接池、超时、熔断、降级
案例 3:可用区故障
- 假设:一个 AZ 不可用,服务仍可用
- 注入:Node drain/AZ 隔离
- 观察:Pod 迁移、PDB、DNS 切流、RTO
- 结果:部分有状态服务恢复超时
- 改进:多 AZ 部署、PDB、备份恢复演练
案例 4:Kafka Broker 故障
- 假设:停 1 个 Broker,生产/消费不中断
- 注入:Pod kill/网络隔离
- 观察:ISR、leader 选举、lag
- 结果:ISR 收缩,短时延迟升高
- 改进:副本因子、min.insync.replicas、容量
案例 5:NameNode 切换
- 假设:Active NameNode 宕机,HDFS 自动切换
- 注入:停 Active NameNode
- 观察:ZKFC、JournalNode、客户端重试
- 结果:切换成功,部分作业重试
- 改进:客户端重试配置、监控、演练频率
附录
常用命令
# Chaos Mesh |